
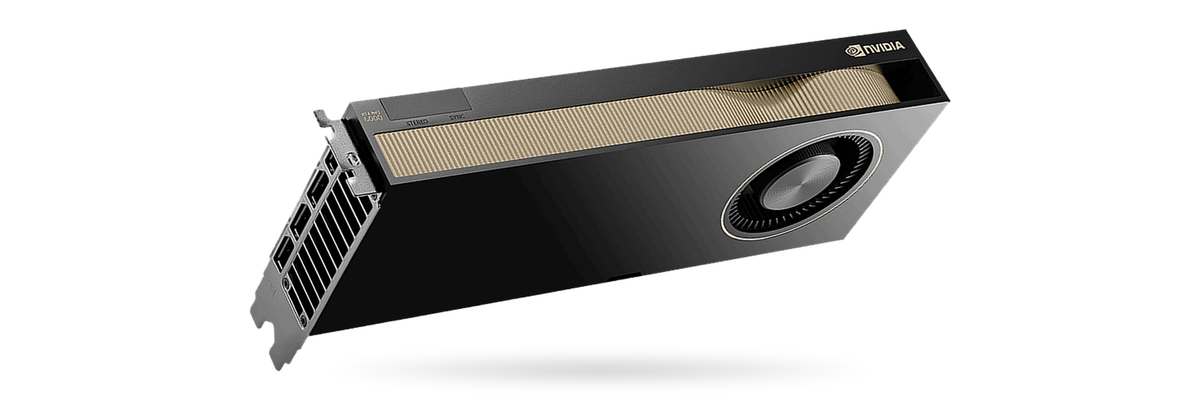
Інтерв'ю можна перетворити на стенограму з розміткою мовців і мітками часу, не віддаючи запис жодному хмарному сервісу: для цього є безкоштовна програма noScribe для Windows, macOS і Linux. На звичайному комп'ютері година розмови, за даними самого проєкту, обробляється від однієї до трьох годин. Відеокарта NVIDIA це очікування скорочує, і для дослідника чи невеликої команди вистачає станції з однією RTX PRO на 24 ГБ.
Матеріал для соціологічних служб, агенцій маркетингових досліджень, редакцій і консалтингових компаній, які пообіцяли респондентам конфіденційність. Нижче про можливості noScribe, українську й російську, час обробки, вимоги Закону № 2297-VI, імпорт у MAXQDA і вибір станції.
Коротко
- Безкоштовна програма noScribe (GPL-3.0) робить стенограми інтерв'ю повністю локально: мовлення розпізнає Whisper через faster-whisper, мовців розмічає pyannote.
- На звичайному комп'ютері година інтерв'ю обробляється від однієї до трьох годин; збірка для Windows з CUDA потребує карти NVIDIA від 6 ГБ і драйвера 570.65 або новішого.
- У режимі «precise» noScribe бере Whisper large-v3-turbo: у рейтингу Handy на FLEURS це 7,31 % WER для української й 5,93 % для російської; README не відносить ці мови до основних.
- Мітки часу [hh:mm:ss] з noScribe MAXQDA читає з файлів DOCX і RTF, тож стенограму, збережену з Word, за нашим прочитанням можна імпортувати з прив'язкою до аудіо.
- Інтерв'ю часто містять особливі категорії даних зі статті 7 Закону № 2297-VI; локальна транскрибація не додає зовнішнього обробника.
Що робить noScribe з інтерв'ю
README описує noScribe як застосунок для якісних стенограм інтерв'ю в соціальних дослідженнях і журналістиці. Він поширюється за GPL-3.0, розпізнає мовлення моделлю Whisper від OpenAI через faster-whisper, а мовців розмічає через pyannote. Офіційний сайт noscribe.de обіцяє, що хмари немає і все лишається на вашому комп'ютері. Інсталятор важить близько 3 ГБ, бо вже містить моделі, тож після встановлення інтернет не потрібен.
| Налаштування | Що робить | Примітка |
|---|---|---|
| Мова | автовизначення, фіксована мова або «multilingual» | multilingual експериментальний |
| Розпізнавання мовців | pyannote із заданою кількістю мовців або «auto» | «none» пропускає крок |
| Одночасне мовлення | позначає, коли двоє говорять разом | експериментально |
| Слова-паразити | записує вигуки й обірвані слова | для моделі це радше «рекомендація» |
| Паузи | «(..)» для паузи у дві секунди | одна крапка на секунду |
| Мітки часу | [hh:mm:ss] при зміні мовця або кожні 60 секунд | потрібні для прив'язки до аудіо |
| Якість | «precise» або «fast» | fast розрахований на повільніші машини |
Джерело: README noScribe на GitHub, прочитано 30.10.2026.
Після обробки редактор відкриває стенограму поруч із записом: Ctrl і пробіл відтворюють аудіо з позиції курсора зі змінною швидкістю, тож імена й числа перевіряють на місці. Версія 0.7 додала пакетну обробку й командний рядок, а останній станом на жовтень 2026 року реліз 0.7.2 додав режим без інтерфейсу для серверів. Результат зберігається в HTML, як звичайний текст або у WebVTT для EXMARaLDA. Проєкт попереджає, що домен noscribe(dot)ai продає платні послуги й до автора не має стосунку; код лежить на GitHub у kaixxx/noScribe.
Українська й російська в noScribe
За README, Whisper розуміє близько 60 мов з дуже різною якістю, і краще за інші іспанську, італійську, англійську, португальську й німецьку. Української й російської в цьому переліку немає, хоча опубліковані вимірювання для обох мов непогані. Режим «precise», за інструкцією зі встановлення в README (прочитано 13.11.2026), використовує faster-whisper-large-v3-turbo; у рейтингу Handy turbo має на FLEURS 7,31 % WER для української й 5,93 % для російської. Повна large-v3 там точніша: 6,28 % і 4,96 %, а в статті NVIDIA (arXiv 2509.14128) 6,51 % і 4,17 %. Це прочитані речення; інтерв'ю з паузами й розмовною лексикою дадуть більше помилок. Порівняння моделей є в статті про розпізнавання української та російської локально.
Респонденти часто переходять з української на російську й назад. Режим «multilingual» проєкт сам називає експериментальним, а вимірювань на суржику чи мішаному мовленні ми не знайшли. Порівняйте на одному типовому інтерв'ю фіксовану мову з «multilingual» і рахуйте помилки в російських фрагментах окремо. З версії 0.6 noScribe приймає власні моделі Whisper, тож large-v3 можна підключити замість turbo. Чи запрацює донавчена на українській BuzzASR/ukrainian (MIT), ми не перевіряли.
Картка pyannote не наводить DER для української чи російської; про моделі діаризації та їхні вимоги до GPU є стаття про діаризацію на власному сервері.
Скільки триває транскрибація на CPU і на GPU
Сайт noScribe дає орієнтир для звичайного комп'ютера: від однієї до трьох годин обробки на годину інтерв'ю, на старих машинах довше, тож завдання радять ставити в чергу на ніч. Відеокарта NVIDIA з CUDA, за сайтом, може суттєво прискорити роботу. Збірка для Windows потребує карти щонайменше з 6 ГБ відеопам'яті, драйвера 570.65 або новішого і встановленого CUDA Toolkit.
Власних замірів на GPU проєкт не публікує. Стаття про Open ASR Leaderboard (arXiv 2510.06961v3) дає для Whisper large-v3 на одній A100-SXM4-80GB з пакетами по 64 RTFx 145,5, тобто 145,5 секунди аудіо за секунду обчислень; за нашим розрахунком, годинне інтерв'ю там розпізнається приблизно за 25 секунд. WhisperX заявляє в пакетному режимі швидкість у 70 разів вищу за реальний час на large-v2 і менше 8 ГБ пам'яті. Ці цифри отримано на іншому залізі без розмітки мовців. Реальний час noScribe визначають режим «precise» чи «fast», розмітка мовців, їхня кількість, якість звуку й карта, тож обробіть на станції одне типове інтерв'ю й плануйте чергу від цього заміру.
Інтерв'ю як персональні дані: що каже Закон № 2297-VI
Дослідницькі й журналістські інтерв'ю часто зачіпають особливі категорії зі статті 7 Закону № 2297-VI: етнічне походження, політичні й релігійні переконання, членство в партіях і профспілках, здоров'я, судимість. Обробляти їх можна лише у винятках частини 2 цієї статті, серед яких однозначна згода людини. Запис голосу з іменем містить персональні дані в будь-якому разі, як і стенограма до псевдонімізації. Потрібна одна з шести підстав статті 11, а за статтею 12 респонденту повідомляють, хто володілець, яка мета, кому дані передають і які в нього права, зокрема відкликати згоду.
Хмарний сервіс транскрибації обробляє записи від вашого імені як розпорядник, і з ним потрібен договір. Якщо дані йдуть за межі ЄЕЗ і держав Конвенції Ради Європи 108, передача можлива лише за винятками частини 4 статті 29, наприклад за явною згодою. Локальна транскрибація зовнішнього учасника не додає. Обробку з особливим ризиком, до якої Уповноважений Верховної Ради України з прав людини відносить, зокрема, дані про здоров'я, повідомляють йому протягом 30 робочих днів після початку (стаття 9).
Три кроки допомагають за будь-якого способу:
- Документи проєкту. Перевірте, що форма згоди й план роботи з даними кажуть про те, хто і де розшифровує записи.
- Шифрування. Тримайте аудіо на зашифрованому диску й видаляйте його тоді, коли цього вимагає згода чи план.
- Рання псевдонімізація. Замініть імена, роботодавців і місця кодами, а таблицю відповідностей зберігайте окремо; заміни може запропонувати локальна мовна модель, а перевіряє людина.
Чи діють особливі правила для наукових досліджень і журналістських джерел, підтвердять юрист чи етична комісія. Законопроєкт № 8153 станом на листопад 2026 року не ухвалений; це загальна інформація, а не юридична консультація.
Від стенограми до MAXQDA, ATLAS.ti чи Word
HTML-файл, за README, відкривається у Word, LibreOffice та програмах якісного аналізу MAXQDA, ATLAS.ti і QualCoder. Для прив'язки до аудіо в MAXQDA стенограма має йти через DOCX або RTF. Довідка MAXQDA (прочитано 30.10.2026) серед розпізнаваних міток часу називає [hh:mm:ss] і формат #hh:mm:ss-x# сервісу f4x, перетворює їх на власні, радить тримати стенограми й медіафайли в одній теці з однаковими назвами і під час імпорту запитує медіафайл.
За нашим прочитанням, мітки noScribe відповідають одному з цих форматів. Увімкніть мітки часу в noScribe, відкрийте HTML у Word чи LibreOffice, збережіть як DOCX поруч з аудіо під тією самою назвою й імпортуйте в MAXQDA як стенограму з мітками часу. Перевірте це на одному інтерв'ю до старту проєкту. Файли субтитрів VTT довідка MAXQDA теж перелічує, тож експорт VTT є другим шляхом.
Правила транскрибування визначають до вибору програми: дослівна стенограма з вигуками, паузами й обірваними словами чи очищена. Налаштування вигуків модель сприймає лише як рекомендацію, тому людина однаково вичитує текст за аудіо.
Яка відеокарта потрібна для транскрибації інтерв'ю
noScribe працює на робочій станції, тож перший рівень стоїть на столі в людини чи команди, яка розшифровує інтерв'ю. Мовна модель додається, коли потрібні підсумки, перші коди або відповіді по багатьох інтерв'ю. Скільки токенів займає година українського інтерв'ю, залежить від токенізатора, і опублікованого підрахунку для gpt-oss ми не знайшли; сесію на 32 768 токенів ми закладаємо на одне інтерв'ю з інструкцією й відповіддю, тож перевірте це на своїй стенограмі.
| Рівень | Обладнання | Що працює | Для кого | Чому |
|---|---|---|---|---|
| Початковий | станція, 1 × RTX PRO 4000 SFF Blackwell (24 ГБ) | noScribe з розміткою мовців | один дослідник або невелика команда, черга на ніч | набагато більше за мінімальні 6 ГБ; Whisper large близько 10 ГБ |
| Початковий із підсумками | станція, 1 × RTX PRO 5000 Blackwell (48 ГБ) | noScribe і gpt-oss-20b | проєктна команда | 17,9 ГіБ лишається на 23 сесії по 32K токенів |
| Середній | станція, 1 × RTX PRO 6000 Workstation Edition (96 ГБ) | noScribe і gpt-oss-120b | соціологічна служба чи агенція з кількома проєктами | 12,9 ГіБ лишається на 11 сесій по 32K токенів |
| Великий | сервер з RTX PRO 6000 Server Edition або L40S | спільний вебзастосунок для транскрибації і LLM | багато проєктів і користувачів одночасно | облікові записи, паралельні завдання, монтаж у стійку |
Джерело: пам'ять GPU за даними NVIDIA; мінімум noScribe за README; Whisper за репозиторієм OpenAI (10 ГБ = 9,3 ГіБ); корисна пам'ять за нашим правилом (90 % пам'яті, яку бачить драйвер, мінус 3 ГіБ, мінус ваги): 40,0 ГіБ на 48 ГБ і 83,0 ГіБ на 96 ГБ; gpt-oss-20b 12,8 ГіБ і 0,75 ГіБ на сесію 32K, gpt-oss-120b 60,8 ГіБ і 1,125 ГіБ на сесію; наша оцінка без моделі діаризації, пам'ять якої картка не вказує.
Початковий рівень. RTX PRO 4000 SFF Blackwell має 24 ГБ GDDR7 при 70 Вт, учетверо більше за мінімум noScribe. Цього досить одному досліднику або команді, яка ділить машину й залишає чергу на ніч.
Із підсумками. На RTX PRO 5000 Blackwell (48 ГБ, 300 Вт) лишається 40,0 ГіБ; gpt-oss-20b забирає 12,8, Whisper близько 9,3, а решта 17,9 ГіБ вміщує 23 сесії, тож кілька людей можуть одночасно просити підсумки чи перші коди. Те, що пише модель, лишається чернеткою для дослідника. Якість українською перевірте окремо: на граматичному бенчмарку UNLP 2026 навіть gpt-oss-120b набирає близько 55 %.
Середній рівень. Станція з RTX PRO 6000 Blackwell Workstation Edition (96 ГБ, 600 Вт) запускає gpt-oss-120b поруч із транскрибацією і, за нашою оцінкою, бере з розетки близько 1,1 кВт, що витримує звичайна офісна лінія 230 В. Друга така карта подвоює місце для паралельної роботи, і дві є практичною межею для цієї версії. Через відключення таку станцію варто підключати через ДБЖ (див. статтю про живлення станції з кількома GPU).
Великий рівень. Коли багато проєктів працюють одночасно, а записи завантажують через браузер, робота переходить на спільний сервер; вебзастосунки для цього порівняно в статті про альтернативу Otter на власному сервері. Конфігурацію під кількість інтерв'ю на місяць ETE рахує від реального навантаження.
Налаштування noScribe на станції з GPU
- Збірка з CUDA. У Windows потрібні щонайменше 6 ГБ відеопам'яті, драйвер NVIDIA 570.65 або новіший, CUDA Toolkit і перезавантаження. Карти RTX PRO Blackwell мають обчислювальну здатність 12.0; першою транскрибацією перевірте, що GPU задіяно.
- Командний рядок.
noScribe.exe --helpпоказує параметри,--no-guiзапускає обробку зі скриптів. - Без мережі. Моделі входять до інсталятора; якщо цього вимагають ваші правила, заблокуйте вихідний трафік станції.
- Спільний сервер. WhisperX 3.8.6 (25.05.2026, BSD-2-Clause) додає мітки часу для слів і діаризацію pyannote; для неї потрібні токен Hugging Face і прийняті умови моделі. Типові моделі вирівнювання WhisperX для німецької, французької, іспанської та італійської мають некомерційну ліцензію CC BY-NC 4.0. Для української й російської WhisperX бере інші моделі, тож перед комерційним використанням перевірте ліцензію саме тієї, що вирівнює ваші записи.
- Зберігання. Зашифруйте диск із даними, включіть його в план резервного копіювання й задайте строки видалення для кожного проєкту.
- Одна карта, дві програми. Якщо мовна модель працює у vLLM поруч із noScribe, зменште
--gpu-memory-utilizationвід типових 0.92, бо vLLM резервує цю частку пам'яті під час старту.
Часті питання
Чи можна розшифрувати інтерв'ю локально, без хмари?
Так. noScribe працює у Windows, macOS і Linux і транскрибує на вашому комп'ютері з розміткою мовців і мітками часу. Моделі постачаються з інсталятором, тож інтернет не потрібен.
Чи розпізнає noScribe українську мову?
Так, через Whisper. Типова модель режиму «precise», large-v3-turbo, має в рейтингу Handy 7,31 % WER на українському FLEURS; повну large-v3 (6,28 %) можна підключити як власну модель. Для мішаного українсько-російського мовлення є лише експериментальний режим «multilingual», тож перевірте точність на власному інтерв'ю.
Скільки відеопам'яті потрібно noScribe?
Збірка з CUDA для Windows працює з картами NVIDIA від 6 ГБ і драйвером 570.65 або новішим. Карта на 24 ГБ вміщує noScribe і Whisper large із запасом.
Скільки часу займає розшифровка години інтерв'ю?
На звичайному комп'ютері від однієї до трьох годин, за даними noscribe.de. Замірів на GPU проєкт не публікує, тож обробіть на станції одне своє інтерв'ю.
Як імпортувати стенограму noScribe в MAXQDA?
Увімкніть мітки часу [hh:mm:ss], збережіть HTML як DOCX у Word, покладіть файл поруч з аудіо під тією самою назвою й імпортуйте як стенограму з мітками часу. Так ми прочитали довідку MAXQDA, тож спершу перевірте на одному інтерв'ю.
Чи потрібна згода респондента на транскрибацію?
Потрібна одна з шести підстав статті 11 Закону № 2297-VI, а для особливих категорій, як-от здоров'я чи політичні погляди, зазвичай однозначна згода за статтею 7. Мету й права респонденту повідомляють заздалегідь; деталі підтвердить юрист.
Що з цього є в ETE
- NVIDIA RTX PRO 4000 SFF Blackwell 24 ГБ: noScribe і Whisper large із запасом при 70 Вт.
- NVIDIA RTX PRO 5000 Blackwell 48 ГБ: транскрибація й gpt-oss-20b для підсумків на одній карті.
- ETE AI Workstation: RTX PRO 6000 на 96 ГБ для gpt-oss-120b поруч із noScribe, із запасом під другу карту.
- NVIDIA L40S 48 ГБ: серверна карта для спільного сервісу транскрибації.
Потрібна станція для розшифровки інтерв'ю?
Напишіть, скільки інтерв'ю на місяць ви записуєте, якими мовами говорять респонденти і скільки людей працюватиме зі стенограмами. ETE порахує конфігурацію, а за потреби інженери Vixen.UNO встановлять noScribe і локальну мовну модель.










