
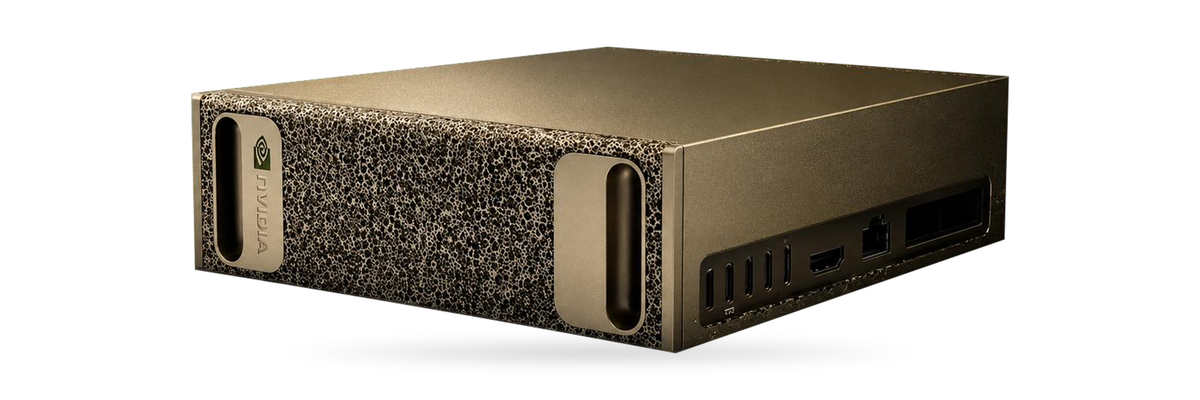
Залізо під локальний AI-асистент для коду рахують від кількості сесій агентів, що працюють одночасно, і від довжини їхніх промптів. За нашим розрахунком, одна RTX PRO 6000 вміщує Qwen3-Coder-30B-A3B у FP8 і 8 сесій по 64K токенів (17 з кешем у FP8), H200 NVL вміщує 15, а DGX Spark підходить для пілоту чи невеликої команди. Цифри наведено станом на жовтень 2026 року.
Коротко
- Доповненню коду потрібні мала модель fill-in-the-middle і низька затримка, а агенти на кожному кроці надсилають промпти на десятки тисяч токенів.
- Qwen3-Coder, gpt-oss і Devstral Small 2 мають ліцензію Apache 2.0; Devstral 2, Codestral 22B і Qwen2.5-Coder-3B обмежують комерційне або промислове використання.
- За нашим розрахунком із config.json, Qwen3-Coder-30B-A3B потребує 6 ГіБ кешу на сесію 64K токенів у BF16, і RTX PRO 6000 вміщує ваги у FP8 разом із 8 такими сесіями, а з кешем у FP8 із 17.
- H200 NVL поруч із тією самою моделлю тримає 15 сесій, дві RTX PRO 6000 з окремою копією моделі на кожній 16.
- За таблицею NVIDIA для Qwen3-30B-A3B у FP4 одна RTX PRO 6000 Server Edition завершує близько 22 викликів із промптом 32K токенів за хвилину на всіх разом.
Доповнення, чат і агенти: три різні навантаження
Доповнення коду підказує текст під час набору: розширення IDE надсилає код до і після курсора, модель дописує середину (fill-in-the-middle, FIM), і підказка корисна, лише якщо приходить раніше за наступне натискання клавіші. Тут потрібна мала спеціально навчена модель. Continue зазначає, що більшість сильних моделей автодоповнення мають не більше 10 млрд параметрів, і локально радить ollama run qwen2.5-coder:1.5b: 986 МБ, 1,54 млрд параметрів, Apache 2.0, контекст 32K. Qwen3-Coder теж підтримує FIM.
У чаті розробник питає про вставлений фрагмент коду, і промпти мають кілька тисяч токенів. На одному DGX Spark, за цифрами розробників llama.cpp, Qwen3-Coder-30B-A3B у 8-бітному форматі з промптами 4 096 токенів дає 15 токенів/с на запит при 8 одночасних запитах і 10 при 16.
Агенти редагують файли й виконують команди кроками, і кожен крок несе моделі всю задачу: інструкції, прочитані файли, вивід команд і попередні кроки. Промпти виростають до десятків тисяч токенів, і документація Ollama вимагає для агентів щонайменше 64 000 токенів контексту.
Чому агенти змінюють розрахунок
Читання промпту навантажує обчислення, а генерацію обмежує пропускна здатність пам'яті. У тесті агентів на DGX Spark (березень 2026) NVIDIA запускала Qwen3 Coder Next у FP8 на vLLM: промпт на 128K токенів читався 54 секунди, повна відповідь була готова через 89. З промптами 32K і відповідями 1K одна задача тривала 35 секунд, дві одночасно 54, чотири 91 (медіанний перший токен через 9, 12 і 15 секунд).
На llama.cpp промпти стають у чергу: Qwen3-Coder-30B-A3B читає на Spark від 2 700 до 2 900 токенів за секунду за будь-якої кількості запитів, тож вісім промптів по 8 192 токени займають 24 секунди до відповіді останнього.
Таблиці TensorRT-LLM від NVIDIA на максимальній пропускній здатності містять Qwen3-30B-A3B, яка за шарами, головами й експертами збігається з Coder. У FP4 на одній RTX PRO 6000 Server Edition вона видає 9 938 вихідних токенів/с при промптах і відповідях по 1 000 токенів, 1 914 при промптах 8 192 і 374 при промптах 32 768 (відповіді по 1 024 токени). За нашим розрахунком, це близько 22 завершених викликів на 32K за хвилину на всю карту, спільних для всіх агентів.
Кешування префіксів цю ціну зменшує: наступний виклик агента зазвичай починається з тих самих токенів, і vLLM, SGLang (RadixAttention) та TensorRT-LLM повторно використовують закешовану частину, поки вона в пам'яті. Наведені тести цього не враховують.
Відкриті моделі для коду та їхні ліцензії
| Модель | Параметри: усього / активних | Ваги | Кеш на сесію 64K, BF16 |
|---|---|---|---|
| gpt-oss-20b | 21 млрд / 3,6 млрд | 13,8 ГБ, MXFP4 | 1,5 ГіБ |
| Devstral Small 2 (24B) | 24 млрд, щільна | 25,8 ГБ, FP8 | 10 ГіБ |
| Qwen3-Coder-30B-A3B | 30,5 млрд / 3,3 млрд | 61,1 ГБ BF16, 31,2 ГБ FP8 | 6 ГіБ |
| gpt-oss-120b | 117 млрд / 5,1 млрд | 65,3 ГБ, MXFP4 | 2,25 ГіБ |
| Qwen3-Coder-Next | 80 млрд / 3 млрд | 159,3 ГБ BF16, 80,4 ГБ FP8 | 1,5 ГіБ |
| Qwen3-Coder-480B-A35B | 480 млрд / 35 млрд | 960,3 ГБ BF16, 482,1 ГБ FP8 | 15,5 ГіБ |
Джерело: параметри й ліцензії за картками моделей і API Hugging Face, вересень 2026; ваги як розмір файлів для gpt-oss і байти тензорів для решти; кеш у BF16 за нашим розрахунком із config.json кожної моделі, кеш у FP8 удвічі менший.
Усі шість моделей мають ліцензію Apache 2.0 і дозволяють комерційне використання. Devstral 2 (123B) має змінену ліцензію MIT, яка виключає компанії з місячним доходом понад поріг; Codestral 22B за Mistral AI Non-Production License можна використовувати лише для тестування, досліджень, особистих цілей і оцінки поза робочим середовищем; Qwen2.5-Coder-3B має ліцензію Qwen Research лише для некомерційних цілей, хоча моделі на 1,5B і 7B вийшли під Apache 2.0.
Станом на 16 жовтня 2026 року документація Mistral відносить Devstral 2 і Devstral Small 2 до застарілих моделей свого API, але ваги лишаються на Hugging Face. Новіші моделі потребують значно менше кешу: одна RTX PRO 6000 вміщує Qwen3.6-35B-A3B (Apache 2.0) у FP8 і 18 сесій по 128K токенів, як показано в статті про Claude Code з локальною моделлю.
Пам'ять: ваги плюс окремий кеш на кожну сесію
Кожна відкрита сесія тримає власний кеш ключів і значень (KV-кеш). На токен він займає 2 × шари × голови ключів і значень × розмірність голови × байти на значення, а цифри беруть із config.json. Qwen3-Coder-30B-A3B має 48 шарів, 4 голови ключів і значень і розмірність 128: 96 КіБ на токен у BF16, 6 ГіБ на сесію 64K і 24 ГіБ на рідних 256K. Devstral Small 2 з 40 шарами й 8 головами потребує 160 КіБ на токен і 10 ГіБ на сесію.
Моделям, які бачать увесь контекст лише в частині шарів, потрібно менше: у gpt-oss-120b половина з 36 шарів має ковзне вікно на 128 токенів, тож лишається 36 КіБ на токен, а Qwen3-Coder-Next тримає кеш у 12 із 48 шарів (24 КіБ на токен), решта мають лінійну увагу з фіксованим станом до 80 МіБ на запит за нашою оцінкою. Кеш у FP8 (--kv-cache-dtype fp8 у vLLM) удвічі зменшує цифри на токен і без каліброваних масштабів може погіршити точність.
Ваги й кеш мають уміститися в пам'ять, доступну рушію. За нашим правилом це 90 % пам'яті, яку показує драйвер, мінус близько 3 ГіБ на карту для активацій і CUDA graphs, тож кількості сесій нижче є стелею: 61,5 ГіБ на RTX PRO 5000 72 ГБ (масштабовано з 95,6 ГіБ карти на 96 ГБ до 71,7 ГіБ), 83,0 ГіБ на карті 96 ГБ і 123,4 ГіБ на H200 NVL. Реальну цифру vLLM друкує під час запуску як максимальну паралельність для заданого контексту.
Скільки сесій агентів вміщує кожна конфігурація
Залізо рахують за одночасними сесіями: працюючий агент тримає довгий контекст, а запити доповнення й чату короткі.
| Конфігурація | Корисна пам'ять | Coder 30B-A3B, FP8 | Coder-Next, FP8 | Дані NVIDIA |
|---|---|---|---|---|
| DGX Spark 128 ГБ | від 102 до 115 ГБ | від 10 до 13 (від 21 до 26) | працює, тестова модель NVIDIA | чотири агентні задачі по 32K одночасно: 91 с (vLLM) |
| RTX PRO 5000 72 ГБ | 61,5 ГіБ | 5 (10) | не вміщується | не знайдено |
| RTX PRO 6000 96 ГБ | 83,0 ГіБ | 8 (17) | близько 5 (9) | Qwen3-30B-A3B у FP4: 374 вихідних токени/с з промптами 32K, 9 938 з 1K (Server Edition) |
| 2 × RTX PRO 6000 | 166,1 ГіБ | 16 (34) двома копіями | близько 57 (110) на обидві | одна копія на дві карти (експертний паралелізм, DEP2): 8 409 на карту з промптами 1K проти 9 938 на одній |
| 4 × RTX PRO 6000 Server Edition | 332,2 ГіБ | 32 (68) чотирма копіями | близько 114 (220) двома парами | не знайдено |
| H200 NVL | 123,4 ГіБ | 15 (31) | близько 30 (58) | gpt-oss-120b у FP8 на H200 SXM: 519 вихідних токенів/с з промптами 32K |
Джерело: сесії по 64K токенів поруч із моделлю у FP8, кеш BF16 (у дужках кеш FP8), наш розрахунок; для Coder-Next враховано до 80 МіБ стану лінійної уваги на сесію; робочий обсяг DGX Spark 0,8 і 0,9 спільної пам'яті, а при 0,7 зі скрипта запуску vLLM від NVIDIA (близько 90 ГБ) Coder 30B-A3B вміщує близько 9 (18) сесій; блог NVIDIA про DGX Spark, березень 2026; таблиці TensorRT-LLM (документація 1.3.0rc29, прочитано 05.10.2026), вихідні токени/с на GPU, відповіді 1 024 токени після промптів 32K і 1 000 після 1K.
DGX Spark раніше впирається в швидкість, ніж у пам'ять; його тести зібрано в статті про DGX Spark. На RTX PRO 5000 72 ГБ gpt-oss-120b не лишає місця навіть на одну сесію 64K (близько 0,7 ГіБ).
Дві RTX PRO 6000 дають найбільшу пропускну здатність як дві копії моделі: розділена експертним паралелізмом копія видавала з промптами 1K 8 409 токенів/с на карту проти 9 938 на одній, зате вміщує 22 сесії 64K проти 16 (кеш BF16). Qwen3-Coder-Next чотири карти ефективніше тримають двома парами: з 2 головами ключів і значень розділення на чотири дублювало б кеш, а vLLM без NVLink вимикає власний all-reduce для більш ніж двох GPU. Вимірювань такої схеми немає, тож заплануйте навантажувальний тест. Сервери на команди від 20 до 100 розробників розраховано в статті про сервер для агентів кодування.
H200 NVL як карта Hopper працює з FP8, але не з FP4, і має приблизно на 16 % менше обчислень у FP8, ніж H200 SXM із таблиці (ті самі 141 ГБ і 4,8 ТБ/с). Qwen3-Coder-480B-A35B потребує багатокарткового сервера: чотири H200 NVL після 482,1 ГБ ваг у FP8 лишають близько 44 ГіБ на кеш, тобто п'ять сесій 64K з кешем у FP8. ETE рахує конфігурацію від кількості одночасних сесій агентів і запланованої довжини контексту.
Запуск моделі й підключення IDE
Для команди основну модель обслуговують vLLM або SGLang з безперервним пакетуванням запитів. Виклик інструментів для агентів у vLLM вмикають --enable-auto-tool-choice разом із парсером моделі, у SGLang достатньо парсера: для Qwen3-Coder-Next це --tool-call-parser qwen3_coder, для Devstral Small 2 у vLLM --tool-call-parser mistral. Контекст задавайте той, який справді плануєте: --max-model-len у vLLM, --context-length у SGLang.
Модель доповнення запускайте окремим малим екземпляром, за потреби на власній GPU: vLLM обслуговує одну модель на сервер. llama-server має ендпойнт /infill для FIM, а Ollama приймає suffix у сумісному з OpenAI ендпойнті completions. Посібник NVIDIA для DGX Spark поєднує Continue з Ollama і gpt-oss:120b, але відкриває Ollama в мережу (OLLAMA_HOST=0.0.0.0:11434, OLLAMA_ORIGINS=*), тож для пілоту потрібен проксі попереду.
Ollama потрібна 0.35.0 або новіша: старіші вразливі до CVE-2026-103663 (8 жовтня 2026 року), через яку неавтентифікований запит до /api/pull може записувати файли поза сховищем моделей, а за права запису в /usr/lib/ollama після перезапуску виконати код від root. vLLM потрібна 0.31.0 або новіша з виправленням GHSA-h3rc-6mm3-gc2m, а краще 0.33.0 від 2 листопада 2026 року, чиї збірки під CUDA 13.0 вимагають драйвера R580 або новішого.
Станом на жовтень 2026 року IDE з власною моделлю з'єднують два відкриті розширення, які ще підтримуються. Cline (Apache 2.0) редагує файли й виконує команди з дозволу користувача, підключається як провайдер OpenAI Compatible і для локальних моделей радить «Use Compact Prompt». Kilo Code (MIT) працює з OpenAI Compatible, Ollama і LM Studio, проте його автодоповнення, за документацією (31.10.2026), іде через Kilo Gateway. Continue після фінального релізу 2.0.0 доступне лише для читання, а Roo Code закрили 15 травня 2026 року. Інструменти для команд порівняно в статті про альтернативи GitHub Copilot.
Вихідний код лишається в мережі: доступ, журнали, працівники
Усі ендпойнти тримайте у внутрішній мережі за проксі з автентифікацією. Ollama за замовчуванням слухає 127.0.0.1 і ігнорує ключі API, проте її контейнерний образ задає OLLAMA_HOST=0.0.0.0:11434, і з -p 11434:11434 API без автентифікації відкрито на всіх адресах хоста. vLLM слухає всі інтерфейси, якщо не задано --host, а його --api-key облікових записів не веде й захищає лише шляхи під /v1, /v2, /inference і /cohere, лишаючи відкритими, наприклад, /pause і /update_weights.
На проксі журналюйте, хто, коли й з якою кількістю токенів викликав яку модель; промпти містять вихідний код, тож вирішіть, чи зберігати їх узагалі. Журнали з прив'язкою до розробника є персональними даними працівників за Законом № 2297-VI: потрібна підстава за статтею 11 (обробка даних працівників можлива на підставі трудових відносин) та інформування про мету й права за статтею 12. Умови моніторингу доводять до працівника заздалегідь і під підпис (ст. 29 КЗпП), а мету й порядок моніторингу закріплюють у локальному акті. Розширення спрямовуйте лише на свій ендпойнт і перевірте телеметрію: у Cline її можна вимкнути, а код, файли й розмови вона, за документацією, не містить. Ця довідка не є юридичною консультацією.
Часті питання
Які відкриті моделі для коду компанія може використовувати комерційно?
Усі три Qwen3-Coder, обидві gpt-oss і Devstral Small 2 мають Apache 2.0. Devstral 2 виключає компанії з місячним доходом понад поріг, Codestral 22B дозволено лише поза робочим середовищем, Qwen2.5-Coder-3B лише для некомерційного використання.
Скільки відеопам'яті потребує сесія агента на 64K токенів?
Для Qwen3-Coder-30B-A3B це 6 ГіБ KV-кешу в BF16 або 3 ГіБ у FP8 понад ваги. Devstral Small 2 потребує 10 ГіБ, gpt-oss-120b 2,25 ГіБ, Qwen3-Coder-Next 1,5 ГіБ плюс невеликий фіксований стан.
Чи потягне один DGX Spark асистента для команди?
Для чату Qwen3-Coder-30B-A3B у 8-бітному форматі на llama.cpp дає близько 15 токенів/с на запит при 8 одночасних запитах із промптами 4 096 токенів, а агентна задача з промптом 32K у тесті NVIDIA тривала 35 секунд, чотири разом 91, тож це рівень пілоту.
Скільки розробників обслуговує одна RTX PRO 6000?
Рахуйте одночасні сесії агентів: з Qwen3-Coder-30B-A3B у FP8 карта вміщує 8 сесій по 64K з кешем BF16 і 17 з кешем FP8. За таблицею NVIDIA для Qwen3-30B-A3B у FP4 це близько 22 викликів із промптами 32K за хвилину на всіх разом.
Що з цього є в ETE
- NVIDIA DGX Spark: пілот для невеликої команди; на ньому NVIDIA тестувала агентів.
- NVIDIA RTX PRO 6000 Server Edition 96 ГБ: Qwen3-Coder-30B-A3B у FP8 і 8 сесій по 64K (17 з кешем FP8) на карту.
- ETE AI Server RTX PRO: чотири RTX PRO 6000 Server Edition по 96 ГБ у 4U, тобто 32 сесії 64K чотирма копіями Qwen3-Coder-30B-A3B (68 з кешем FP8) або Qwen3-Coder-Next двома парами.
- NVIDIA H200 NVL 141 ГБ: 15 сесій поруч із Qwen3-Coder-30B-A3B; чотири карти тримають Qwen3-Coder-480B-A35B у FP8.
Потрібен сервер під асистента для ваших розробників?
Напишіть, скільки розробників працює з агентами одночасно, яку довжину контексту плануєте і чи може код виходити за межі вашої мережі. ETE порахує конфігурацію, а за потреби інженери Vixen.UNO розгорнуть vLLM з моделлю й підключать IDE.










