
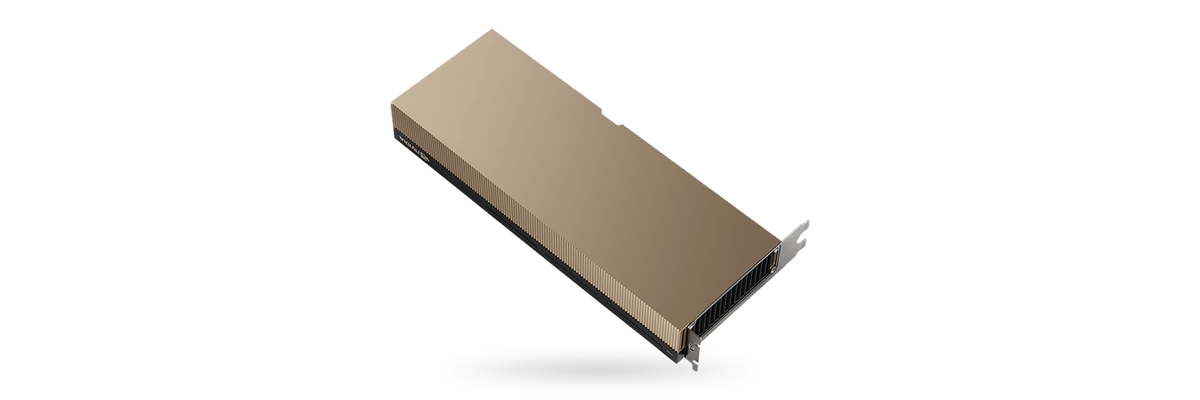
Text-to-SQL локально дає змогу поставити запитання до бази ERP чи CRM так, як ви написали б колезі, і отримати цифру з власних даних без хмарного сервісу. Мовна модель на робочій станції в офісі перекладає запитання мовою запитів SQL, база виконує запит від облікового запису, якому дозволено лише читати, а результат повертається таблицею чи графіком разом із текстом запиту. Запитання, структура таблиць і відповіді при цьому не залишають компанії. Для відділу контролінгу чи продажів практична точка старту: одна NVIDIA RTX PRO 5000 Blackwell на 48 ГБ.
Типові запитання звучать так: «які клієнти цього кварталу замовили менше, ніж у тому самому кварталі торік» або «відкриті замовлення понад певну суму в розрізі менеджерів». За кожним стоїть кілька таблиць, які треба правильно з'єднати, і фільтр, що рахує так, як заведено саме у вас. Пошук у документах є окремою задачею (див. статтю про RAG на корпоративних даних): він знаходить уривок тексту, а text-to-SQL обчислює число, і хибний фільтр дає впевнену, але неправильну цифру.
Коротко
- Найсильніше на результат впливає семантичний шар: представлення з читабельними назвами, визначення показників і перевірені приклади.
- На бенчмарку BIRD окрема модель із відкритими вагами, що стоїть у рейтингу найвище, дає 74,12 % правильних результатів, люди 92,96 % (стан на 30.10.2026).
- DB-GPT (MIT) і SQL-агент LangChain (MIT) працюють із локальними моделями, а репозиторій Vanna в березні 2026 року архівовано.
- За нашим правилом розрахунку RTX PRO 5000 Blackwell на 48 ГБ тримає Qwen3.8-27B у 8 бітах і 16 одночасних запитань по 10 000 токенів, версія на 72 ГБ 44.
- Безпеку дають права в базі: SELECT лише на підготовлені представлення, копія для звітності, журнал кожного запиту.
Наскільки точно модель пише SQL
BIRD охоплює 95 баз даних і зараховує відповідь, якщо результат згенерованого запиту збігається з результатом еталонного.
| Учасник BIRD, тестовий набір | Що оцінюють | Правильних результатів, % |
|---|---|---|
| Люди: інженери даних і студенти, що вивчають бази даних | еталон | 92,96 |
| Перше місце основного рейтингу (запис від 22.10.2026) | система повністю | 83,40 |
| Gemini-SQL2 (Google) | окрема модель, без посилання на ваги | 80,04 |
| Kwai-AutoSQL-32B | окрема модель, ваги на Hugging Face | 74,12 |
Джерело: лідерборд BIRD, стан на 30.10.2026.
Навіть із сильною відкритою моделлю приблизно кожна четверта відповідь на публічному тесті хибна, а корпоративні бази зазвичай заплутаніші за BIRD. Інструмент однаково стає корисним, якщо дотримуватися трьох правил:
- показувати SQL з кожною відповіддю, щоб людина, яка знає дані, помітила неправильне з'єднання таблиць;
- вести бібліотеку перевірених запитань із правильними запитами, яку інструмент використовує як приклади;
- позначати відповіді з перевіреного запиту інакше, ніж нові.
Складніший бенчмарк Spider 2.0 побудовано на корпоративних базах, де нерідко понад 1 000 колонок. На його наборі Snowflake gpt-oss-120b в одному агентному фреймворку набрав 65,45, а в іншому 13,10. Тобто обгортка навколо моделі (як вона бачить схему, перевіряє й виправляє запити) важить не менше за саму модель.
Опублікованих вимірювань точності text-to-SQL для запитань українською чи російською ми не знайшли, тож тестовий набір складайте з того, як реально пишуть ваші люди, обома мовами.
Семантичний шар: ваші бізнес-терміни для моделі
Модель бачить лише назви таблиць і колонок. Навіть зрозумілі назви не пояснюють, що у вашій компанії вважають виручкою, які статуси замовлення означають скасування і за якою датою замовлення потрапляє в квартал. Цю прогалину закриває семантичний шар: письмовий опис даних бізнес-мовою, розташований між базою і моделлю. У ньому сказано, що означає кожна таблиця, які з'єднання дозволені й за якою формулою рахується кожен показник.
Як такий шар виглядає, видно з контекстного шару WrenAI. Його мова моделювання (Modeling Definition Language) описує моделі, колонки, зв'язки, представлення, куби й метрики, а два звичайні файли, instructions.md і queries.yml, містять переліки допустимих значень, одиниці виміру, дозволені з'єднання й визначення. Обійтися можна і без WrenAI:
- ІТ-відділ створює в базі кілька представлень (views), тобто збережених запитів, які виглядають як таблиці, з читабельними назвами під важливі запитання: продажі за клієнтом і місяцем, відкриті замовлення з відповідальним менеджером.
- До кожної колонки дописує одне речення пояснення.
- Додає перевірені приклади запитань із правильними запитами.
Після цього модель звертається лише до представлень, а сирі таблиці ERP лишаються поза її досяжністю. Від цього кроку результат залежить сильніше, ніж від вибору моделі: двадцять визначень і тридцять перевірених запитань від контролера дають інструменту те, що знає досвідчений колега. Шар зберігають у Git, щоб кожна зміна визначень мала дату й проходила перегляд.
Доступ лише для читання до бази ERP і CRM
Справжня межа безпеки проходить через обліковий запис, під яким інструмент заходить у базу. Документація LangChain радить обмежувати права підключення так вузько, як цього потребує агент. Заборона змінювати дані в промпті лишається реченням у тексті, а виконують її тільки права в базі.
- Копія замість робочої системи. Запити йдуть до репліки для звітності або до сховища даних, щоб важкий запит не гальмував введення замовлень. Чи дозволяє договір підтримки прямий доступ до бази ERP, уточніть у постачальника системи.
- Окремий користувач лише для читання. Права SELECT на представлення семантичного шару і більше нічого. У PostgreSQL
default_transaction_read_onlyзадає тільки значення за замовчуванням, яке сесія може змінити, тож вирішують права;statement_timeoutдля цього облікового запису зупиняє надто довгі запити. - Правила на рівні рядків. Якщо менеджер бачить лише своїх клієнтів, це правило живе в базі, і база мусить знати, хто питає: спільний обліковий запис бачить усе, що дозволено його ролі. Тому кожна команда отримує власну роль і власне підключення в інструменті. У PostgreSQL представлення створюють із
security_invoker = true, бо за замовчуванням вони застосовують правила рядків свого власника, а не того, хто запитує. - Перевірка й журнал. Один оператор SELECT на запитання, обмеження кількості рядків, а в журнал записують запитання, SQL і користувача.
Нотатки про клієнтів і вільні текстові поля можуть містити інструкції, які потраплять у контекст моделі (ін'єкція промпту). Що така інструкція зможе зробити, обмежують ті самі права в базі.
Дані клієнтів у CRM лишаються персональними даними й на власному сервері. За Законом № 2297-VI обробка потребує однієї з шести підстав статті 11 (згода, договір, законний інтерес тощо), а людям повідомляють мету обробки та їхні права (стаття 12). Власний сервер прибирає зовнішнього постачальника, але цих обов'язків не знімає, а рішення з правовими наслідками для людини не варто віддавати лише моделі (стаття 8 дає право на захист від автоматизованого рішення). Наближений до GDPR законопроєкт № 8153 станом на листопад 2026 року не ухвалений. Це не юридична консультація, деталі підтвердить ваш юрист.
Відкриті інструменти text-to-SQL: DB-GPT, LangChain, WrenAI, Vanna
Стан цих проєктів протягом 2026 року змінювався, тож перевіряйте його перед стартом.
| Інструмент | Ліцензія | Локальна модель | Стан на 30.10.2026 |
|---|---|---|---|
| DB-GPT | MIT | vLLM, llama.cpp, OpenAI-сумісні сервери | активний, останній реліз у червні 2026 |
| SQL-агент LangChain | MIT | Ollama та інші через інтеграції | підтримуваний фреймворк, не застосунок |
| WrenAI | ядро Apache 2.0, інтерфейс комерційний | у README не названо | не архівований, відкрита частина для AI-агентів |
| Vanna | MIT | Ollama у переліку | архівований 29.03.2026, лише читання |
Джерело: репозиторії й README на GitHub (Vanna, WrenAI, DB-GPT, LangChain), сторінка релізів DB-GPT, посібник LangChain «Build a SQL agent» і сторінка ChatOllama; прочитано 30.10.2026.
DB-GPT під MIT називає себе «open-source agentic AI data assistant»: приймає запитання природною мовою, пише SQL, будує графіки, дашборди й звіти. Вебінтерфейс працює на порту 5670. Про облікові записи й права користувачів README нічого не каже, тож доступ ставлять перед ним: корпоративний вхід або проксі з автентифікацією, як для чат-інтерфейсів у статті про приватну альтернативу ChatGPT.
SQL-агент LangChain є посібником із будівельними блоками для розробників, а не готовим застосунком. Агент читає перелік і структуру таблиць, складає запит, дає моделі його перевірити, виконує, після помилки виправляє і відповідає. Системний промпт забороняє DML-оператори (INSERT, UPDATE, DELETE, DROP тощо), а HumanInTheLoopMiddleware може зупиняти агента перед кожним запитом, доки людина його не схвалить. Приклади в посібнику працюють із хмарними моделями, проте інтеграція ChatOllama підтримує виклик інструментів із локальною моделлю.
WrenAI описує себе як GenBI для AI-агентів із керованим text-to-SQL через відкритий контекстний шар. Під Apache 2.0 відкрито рушій, SDK і навички, а безпеку на рівні рядків і колонок, керування користувачами, інтерфейс GenBI, дашборди й вбудовування позначено як комерційні.
Vanna («Chat with your SQL database») встигла вийти у версії 2.0 з готовим чат-компонентом, але 29 березня 2026 року власник архівував репозиторій. Виправлень він більше не отримуватиме, тож для нових проєктів його брати не варто.
Яка локальна модель пише SQL
Моделі бувають двох типів. Донавчені під SQL, як-от Kwai-AutoSQL-32B (ваги під Apache 2.0) чи Arctic-Text2SQL-R1-7B від Snowflake (Apache 2.0, 68,5 на тестовому наборі BIRD за карткою моделі), перетворюють запитання й визначення таблиць на один запит. Агентам на зразок DB-GPT чи SQL-агента LangChain потрібна модель загального призначення з викликом інструментів: gpt-oss-20b, gpt-oss-120b (обидві Apache 2.0) або Qwen3.8-27B (Apache 2.0, серпень 2026), картка якої SQL-бенчмарків не наводить. Порівняння цих моделей на схемах, схожих на вашу, не публікували, тож вирішує ваш тест.
Qwen3.8-27B міркує перед відповіддю: картка за замовчуванням ставить найвищий рівень міркування, а для кроків SQL середній чи низький скорочує очікування. Швидкість однієї відповіді залежить від пропускної здатності пам'яті й обсягу даних, прочитаних на кожен токен. RTX PRO 5000 має 1 344 ГБ/с, а 27B-модель у 8 бітах читає близько 28 ГБ на токен, тож верхня межа, за нашою оцінкою, близько 47 токенів/с. Агентові, який у кожному з чотирьох кроків пише по 500 токенів, знадобиться щонайменше близько 43 секунд (теж наша оцінка).
Яка відеокарта потрібна для text-to-SQL
Рахуємо за нашим правилом: 90 % пам'яті, яку показує драйвер, мінус 3 ГіБ на карту, мінус ваги моделі, а решта йде на запитання в обробці. Токен означає слово або його частину. Одне запитання з інструкціями, вибраними представленнями, прикладами й кроками агента в цьому прикладі займає близько 10 000 токенів. Кеш беремо 16-бітний, як його за замовчуванням тримає Ollama.
| Рівень | Карта | Модель і ваги | Запитань одночасно | Для кого |
|---|---|---|---|---|
| Початковий | 1 × RTX PRO 4000 Blackwell, 24 ГБ | gpt-oss-20b, 12,8 ГіБ | 24 | одна команда, кілька представлень |
| Основний | 1 × RTX PRO 5000 Blackwell, 48 ГБ | Qwen3.8-27B 8 біт, 27,9 ГіБ | 16 | контролінг і продажі |
| Із запасом | 1 × RTX PRO 5000 Blackwell, 72 ГБ | Qwen3.8-27B 8 біт, 27,9 ГіБ | 44 | кілька відділів |
| Середній | 1 × RTX PRO 6000 Workstation Edition або Max-Q, 96 ГБ | gpt-oss-120b, 60,8 ГіБ | 64 | більша модель, уся компанія |
Джерело: наша оцінка за правилом розрахунку (корисна пам'ять 18,5; 40,0; 61,5 і 83,0 ГіБ); ваги за тегами Ollama (qwen3.8 q8_0, 30 ГБ) і файлами gpt-oss на Hugging Face; 16-бітний кеш на токен: 24 КіБ для gpt-oss-20b, 64 КіБ плюс 0,14 ГіБ фіксованого стану для Qwen3.8-27B, 36 КіБ для gpt-oss-120b; кеш FP8 у vLLM вміщує більше запитань; не вимірювання.
Запитання в обробці не дорівнюють користувачам: десять керівників рідко питають в одну й ту саму секунду, тож кожне число обслуговує більшу команду. BI-команді з великим сховищем даних потрібен сервер із RTX PRO 6000 Server Edition або H200 NVL. Загальні формули розрахунку пам'яті зібрано в статті про відеопам'ять під LLM. Конфігурацію під ваш тип бази, кількість таблиць і користувачів ETE рахує від реального навантаження.
Пілот на одній предметній області
Зберіть від 50 до 100 справжніх запитань від майбутніх користувачів, а правильну відповідь на кожне хай перевірить той, хто знає дані. Під ці запитання побудуйте представлення й визначення, проженіть їх через кожну модель-кандидата в одному інструменті й порахуйте правильні результати, хибні та відмови. Повторюйте тест після кожної зміни моделі, промпту чи представлень.
Пілот на одній області, наприклад продажах, показує, чи можна довіряти відповідям, до того, як додадуться інші. Перехід від однієї станції до спільного сервера для кількох відділів описано в статті про сервер приватного ChatGPT під розмір компанії. Встановлення моделі, DB-GPT і доступу до бази лише для читання можуть узяти на себе інженери Vixen.UNO.
Часті питання
Чи підтримується ще Vanna AI?
Ні: репозиторій vanna-ai/vanna на GitHub архівовано 29 березня 2026 року (стан на 30.10.2026). Код під MIT доступний, але виправлень не буде. Підтримувані альтернативи з локальними моделями: DB-GPT і SQL-агент LangChain.
Наскільки точний text-to-SQL?
На BIRD люди дають 92,96 % правильних результатів, окрема модель із відкритими вагами, що стоїть у рейтингу найвище, 74,12 %, а перша система основного рейтингу 83,40 % (стан на 30.10.2026). Показуйте згенерований SQL із кожною відповіддю й ведіть бібліотеку перевірених запитань.
Як ставити запитання до бази даних звичайною мовою без хмари?
Підключіть інструмент text-to-SQL, наприклад DB-GPT або SQL-агент LangChain, до моделі на власній робочій станції через vLLM чи Ollama і дайте йому обліковий запис бази лише для читання. Модель пише SQL, база його виконує, а ви бачите відповідь разом із запитом. Точність на запитаннях українською чи російською перевірте на власному пілотному наборі.
Яка відеокарта потрібна для text-to-SQL з локальною моделлю?
За нашим правилом розрахунку RTX PRO 4000 Blackwell на 24 ГБ запускає gpt-oss-20b з 24 одночасними запитаннями, RTX PRO 5000 на 48 ГБ тримає Qwen3.8-27B у 8 бітах із 16, версія на 72 ГБ із 44. Для BI-команди з великим сховищем потрібен сервер.
Чи може ШІ змінити або видалити дані в базі?
Ні, якщо його обліковий запис має право лише читати. Дайте SELECT на вибрані представлення, працюйте з копією для звітності й відхиляйте будь-який згенерований оператор, який не є одним SELECT. Заборона в промпті сама по собі захистом не є.
Що з цього є в ETE
- NVIDIA RTX PRO 5000 Blackwell 48 ГБ: Qwen3.8-27B у 8 бітах і 16 одночасних запитань для контролінгу й продажів.
- NVIDIA RTX PRO 4000 SFF Blackwell 24 ГБ: ті самі 24 ГБ, що в початковому рівні розрахунку: gpt-oss-20b і до 24 одночасних запитань однієї команди.
- NVIDIA RTX PRO 6000 Blackwell Max-Q 96 ГБ: gpt-oss-120b і близько 64 одночасних запитань з усієї компанії.
- ETE AI Workstation: станція з RTX PRO 6000 на 96 ГБ і 256 ГБ ECC-пам'яті під модель, DB-GPT і журнал запитів.
Потрібна станція для запитань до вашої бази?
Надішліть тип бази даних, кількість таблиць, скільки людей питатиме і десять запитань, які ставить ваша команда, тими мовами, якими вони їх пишуть. ETE порахує конфігурацію, а за потреби інженери Vixen.UNO встановлять модель, DB-GPT і налаштують доступ лише для читання.










