
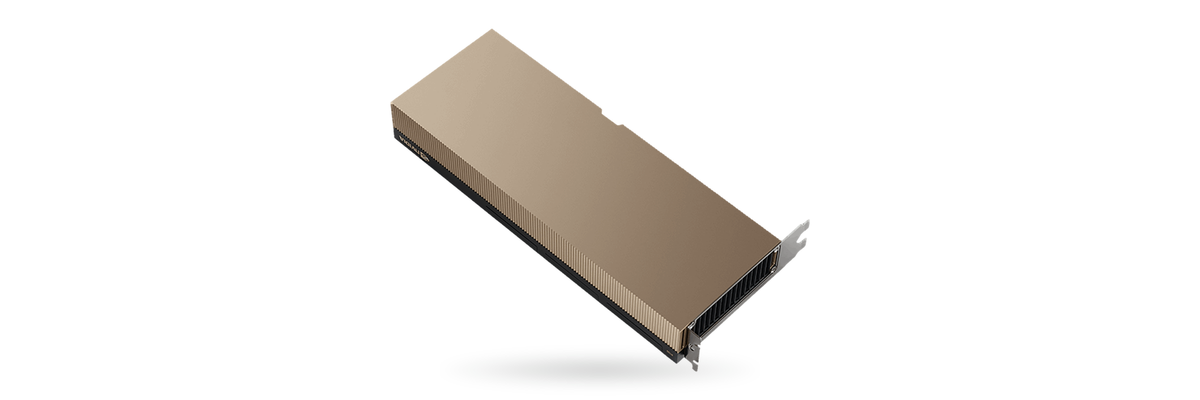
Альтернатива ChatGPT, Claude чи Gemini для компанії працює повністю на її власних серверах. Її складають сервер моделі з API, сумісним з OpenAI (наприклад, vLLM), чат-інтерфейс з обліковими записами (Open WebUI або LibreChat), вхід через ваш провайдер ідентичності, шар документів із правами кожного користувача, журнал запитів і GPU-сервери, розраховані на пікову кількість одночасних запитів. Запити й документи виходять назовні лише через підключення, які ви додали самі.
Коротко
- Ключ --api-key у vLLM захищає не всі маршрути, тому до порту vLLM має діставатися лише хост чат-інтерфейсу.
- LibreChat має ліцензію MIT; власна ліцензія Open WebUI з v0.6.6 не обмежує кількість користувачів усередині компанії, але захищає брендинг, якщо за 30 днів кінцевих користувачів понад 50.
- Обидва інтерфейси підтримують OpenID Connect, SAML напряму є лише в LibreChat; Open WebUI відкриває бази знань групам, тож права на окремі документи перевіряють під час пошуку.
- Аудит-журнал Open WebUI типово вимкнений, обрізає тіла до 2 048 байтів і не бачить відповідей, тому повний запис дає збережена історія чатів або шлюз перед vLLM.
- На одній RTX PRO 6000 на 96 ГБ модель gpt-oss-120b лишає близько 22,2 ГіБ під KV-кеш, тобто приблизно 19 одночасних розмов із заявленим контекстом 32K.
З чого складається приватний чат-асистент
Таблиця перелічує вісім складових і рішення, які доведеться ухвалити на кожній.
| Компонент | Варіанти | Що вирішити |
|---|---|---|
| Сервер моделі | vLLM, SGLang, NVIDIA NIM | модель, точність, заявлений контекст |
| Чат-інтерфейс | Open WebUI, LibreChat | умови ліцензії, функції за ролями |
| Вхід і ролі | OIDC, SAML, LDAP, SCIM | локальний вхід, строк дії токена, доступ до моделей |
| Документи й RAG | завантаження, бази знань, сервіс пошуку | де перевіряються права на документ |
| Журнал запитів | історія чатів, аудит-журнал, шлюз | що зберігати, хто читає, як довго |
| Запобіжники | функції-фільтри, моделі-охоронці | які входи й виходи перевіряти |
| Модель | Apache 2.0 або ліцензії спільноти | умови ліцензії, мови, пам'ять |
| GPU-сервер | за кількістю одночасних запитів | кількість карт, другий хост |
Джерело: документація vLLM, Open WebUI, LibreChat і NeMo Guardrails, прочитано 06.10.2026.
Сервер моделі: vLLM з API, сумісним з OpenAI
vLLM поширюється за Apache 2.0 і є HTTP-сервером, що реалізує Completions API, Chat API та інші API OpenAI; запускають його командою vllm serve з назвою моделі. Опція --api-key перевіряє статичні ключі лише на маршрутах /v1, /v2, /inference і /cohere. Сторінка безпеки vLLM (прочитано 23.10.2026) перелічує маршрути без ключа, зокрема /invocations, /rerank і /update_weights, тому до порту vLLM має діставатися лише хост інтерфейсу. Облікових записів vLLM не має й параметр user ігнорує, тож хто про що питав, знає тільки інтерфейс або шлюз.
--max-model-len ставлять під контекст розмов, а не під максимум моделі, бо від нього залежить, скільки розмов уміщується одночасно. vLLM типово збирає анонімну статистику використання, доки не задано VLLM_NO_USAGE_STATS=1.
Open WebUI чи LibreChat: інтерфейс і ліцензії
Обидва під'єднуються до будь-якого сумісного з OpenAI сервера: Open WebUI через Settings, Admin, Connections з адресою /v1 сервера vLLM, LibreChat через custom endpoint із baseURL у librechat.yaml. Open WebUI шукає в базах знань, за бажанням із BM25 і ререйкінгом; LibreChat має власний RAG API на PostgreSQL з pgvector. Невеликій команді може вистачити AnythingLLM, де чат і пошук документів зібрано в одній програмі.
LibreChat має ліцензію MIT, його окрема адмінпанель AGPL-3.0. Open WebUI з v0.6.6 від 19 квітня 2025 року має власну ліцензію: умови BSD-3 плюс пункт, що забороняє змінювати, прибирати чи замінювати брендинг, якщо в розгортанні понад 50 кінцевих користувачів за будь-які 30 днів поспіль і немає письмового дозволу правовласника або корпоративної ліцензії. Для внутрішнього використання обмежень на кількість користувачів немає, доки брендинг помітний, але ліцензія не схвалена OSI, що важливо, якщо політика компанії допускає лише OSI-ліцензії.
Вхід через SSO: OIDC, SAML, ролі й групи
В обох інтерфейсах вхід працює через OpenID Connect. Open WebUI документує також LDAP і довірений заголовок від проксі, причому помилка в такому налаштуванні дозволяє входити під будь-ким. Нативного SAML у ньому ми не знайшли, тож його під'єднують через брокер на кшталт Keycloak. LibreChat підтримує SAML напряму, але не разом з OpenID Connect і без Single Logout.
Ролі й групи приходять із токена. В Open WebUI OAUTH_ADMIN_ROLES задає ролі адміністраторів, OAUTH_ALLOWED_ROLES ролі, яким вхід дозволено, а ENABLE_OAUTH_GROUP_MANAGEMENT під час кожного входу суворо синхронізує членство з токеном і прибирає вручну призначені групи. Дозволи лише додаються, тож документація радить мінімальні типові права. LibreChat пускає лише перелічені ролі через OPENID_REQUIRED_ROLE і керує правами на функції в адмінпанелі (потрібна v0.8.5 або новіша).
Нові облікові записи Open WebUI отримують статус pending, а ENABLE_LOGIN_FORM=false прибирає локальну форму пароля. Токени сесії типово діють чотири тижні (4w) і без Redis лишаються дійсними після виходу; деактивація їх теж не відкликає, тому адміністратор ще натискає Sign out all devices. Зі SCIM 2.0 користувачів деактивує сам провайдер ідентичності.
Документи, RAG і права на кожен документ
В Open WebUI базу знань відкривають групам або окремим людям через список доступу, а інструмент oikb дзеркалить у неї репозиторії Git, простори Confluence і бакети S3. Список доступу діє на всю базу; механізму, що переносив би в індекс права окремих документів із системи-джерела, у документації ми не знайшли. Onyx синхронізує такі права із SharePoint, Teams і Confluence у платній Enterprise Edition, див. статтю про Onyx на власному сервері.
Коли в колекції одна аудиторія, цього досить. Якщо ж в одному сховищі змішано документи для різних читачів, права перевіряють під час пошуку: фільтр за ідентичністю й групами користувача спрацьовує до ранжування, як пояснено в статті про RAG на даних компанії. В Open WebUI ідентичність у сервіс пошуку передає функція-фільтр, яка отримує повний запис користувача.
Журнал запитів і відповідей: що зберігати і як довго
Open WebUI зберігає розмови у своїй базі. Користувачі видаляють їх, якщо мають дозвіл Allow Chat Delete, а адміністратори читають чужі чати, доки ENABLE_ADMIN_CHAT_ACCESS має типове значення true. Окремий аудит-журнал типово вимкнений; рівень METADATA пише користувача, IP, метод, URL і час, REQUEST_RESPONSE додає тіла, обрізані до 2 048 байтів, а типові винятки /chats, /chat і /folders лишають чат поза журналом. LibreChat типово видаляє тимчасові чати через 720 годин.
Навіть з увімкненими маршрутами чату журнал бачить запит, але не відповідь: текст відповіді приходить у браузер через websocket і зберігається з чатом. Повний запис дає або збережена історія (без права видаляти й без тимчасових чатів), або шлюз між інтерфейсом і сервером моделі, якому Open WebUI з ENABLE_FORWARD_USER_INFO_HEADERS=true передає ім'я, ID, e-mail і роль користувача.
Журнал запитів працівників містить їхні персональні дані. Обробляти їх можна на підставі трудових відносин (ст. 7 і ст. 11 Закону № 2297-VI), а з будь-яким моніторингом працівника, за ст. 29 КЗпП, заздалегідь ознайомлюють під підпис. Наближений до GDPR законопроєкт № 8153 станом на листопад 2026 року не ухвалений, спеціального закону про ШІ в Україні поки немає. EU AI Act може застосовуватися, якщо систему виводять на ринок ЄС або її результати використовують у ЄС. Власний сервер не замінює правової підстави й інформування людей, а строк зберігання журналу визначить ваш юрист.
Публічний API для окремих задач додають ще одним підключенням лише для дозволених груп, і його використання видно в журналі. Direct Connections тримають вимкненими, бо з ними браузер іде до провайдера API напряму, повз сервер і журнал.
Запобіжники й ліцензії відкритих моделей
Функції-фільтри Open WebUI мають inlet перед моделлю й outlet перед користувачем, а глобальний активний фільтр примусово вмикається для всіх моделей. NeMo Guardrails від NVIDIA (Apache 2.0) додає перевірки входу, виходу й пошуку, а моделі gpt-oss-safeguard від OpenAI (теж Apache 2.0) класифікують текст за вашими політиками безпеки.
| Модель | Ліцензія | Що перевірити |
|---|---|---|
| gpt-oss-20b, gpt-oss-120b | Apache 2.0 | політика використання: дотримуватися чинного законодавства |
| Qwen3-32B, Qwen3.8-27B | Apache 2.0 | Qwen3.8-Flash-Next має Qwen Community License 1.0 |
| Gemma 4, від E2B до 31B | Apache 2.0 | Gemma 3 лишається під Gemma Terms of Use |
| Llama 3.3 70B | ліцензія спільноти Llama 3.3 | «Built with Llama» на продуктах; окрема ліцензія Meta понад 700 млн активних користувачів на місяць |
| Llama 4 Scout | ліцензія спільноти Llama 4 | права на мультимодальні моделі не надано компаніям з основним місцем діяльності в ЄС |
| Muse Glimmer 30B (Meta) | Apache 2.0 | Muse Spark Open має власну Muse Model License |
Джерело: картки моделей, файли ліцензій і політики використання Meta, прочитано 06.10.2026, Muse 23.10.2026; політику Llama 4 перечитано 31.10.2026.
Перевіряйте картку кожної моделі. Обмеження Llama 4 варто врахувати, якщо модель використовуватиме європейська компанія вашої групи.
Для асистента українською корисний Ukrainian LLM Leaderboard від lang-uk: у файлі за травень 2026 року найвищі бали має Gemma 4 26B A4B у режимі міркувань, зокрема 86,6 % у MMLU-uk. gpt-oss-120b на граматичному бенчмарку UNLP 2026 набирає близько 55 % українською, а моделі-лідери там набирають близько 60 %. MamayLM v2.0 від INSAIT (12B і 27B на Gemma 3) зроблена для української, але має Gemma Terms of Use.
Скільки GPU потрібно на одночасних користувачів
GPU рахують за кількістю одночасних запитів у пікову годину, а не за штатом. KV-кеш отримує 0,9 від пам'яті, яку показує драйвер, мінус 3 ГіБ і мінус ваги; частку задає gpu_memory_utilization у vLLM, тепер типово 0,92. RTX PRO 6000 на 96 ГБ показує 95,6 ГіБ, тож 0,9 дає 86,0 ГіБ. Чекпойнт gpt-oss-120b з експертними вагами в MXFP4 займає 65,3 ГБ, або 60,8 ГіБ, і лишає близько 22,2 ГіБ. Лише 18 з 36 шарів тримають кеш на весь контекст, решта працює з вікном на 128 токенів, тож токен коштує 36 КіБ кешу в BF16. Розмова із заявленим контекстом 32K потребує 1,125 ГіБ, і одночасно вміщується близько 19 розмов; власну цифру vLLM друкує під час запуску.
| Конфігурація | Як розміщено gpt-oss-120b | Розмов по 32K одночасно |
|---|---|---|
| 1 × RTX PRO 6000, 96 ГБ | одна копія | близько 19 |
| 4 × RTX PRO 6000 Server Edition | чотири окремі копії | близько 76 |
| 4 × RTX PRO 6000 Server Edition | дві копії, кожна на парі карт з тензорним паралелізмом | близько 186 |
Джерело: розрахунок за правилом «0,9 × пам'ять драйвера мінус 3 ГіБ мінус ваги»; пропускну здатність під таким навантаженням не виміряно.
Пара з тензорним паралелізмом зберігає ваги один раз на дві карти, тому розмов уміщується більше. NVLink у цих карт немає, обмін іде через PCIe, а vLLM вимикає власний all-reduce для понад двох GPU без NVLink, тож дві пари вигідніші. Потрібен навантажувальний тест. Розрахунок для 100, 500 і 2 000 працівників є в статті про сервер за розміром компанії, а відмінності версій карти в матеріалі RTX PRO 6000: Workstation, Max-Q і Server Edition.
Уся розмова надсилається з кожним запитом, а prefix caching у vLLM повторно використовує оброблену історію. Open WebUI ще й у фоні викликає модель для заголовків, тегів, підказок і автодоповнення, типово ту саму, що й у чаті; документація радить для цього малу модель без міркувань як другий екземпляр vLLM, а автодоповнення вимикати першим. Для доступності плануйте другу карту в другому хості.
Конфігурацію під ваш пік одночасних запитів ETE рахує від реального навантаження, а розгортання vLLM, Open WebUI чи LibreChat за потреби беруть на себе інженери Vixen.UNO.
Впровадження поетапно: пілотна група, політика, навчання
- Виберіть один процес і пілотну групу та домовтеся про метрики, яких пілот має досягти до розширення.
- Напишіть політику використання: які класи даних можна вводити, які моделі й підключення має кожна група, що журналюється, хто це читає і як довго.
- Під'єднайте SSO з ролями й групами, вимкніть локальний вхід, статистику vLLM і Direct Connections, скоротіть строк дії токена. Станом на 5 листопада 2026 року ставте Open WebUI 0.12.2 або новішу (версії до 0.11.4 дозволяли будь-якому сайту забрати токен сесії) і vLLM 0.32.0 або новішу. vLLM 0.33.0 від 2 листопада виходить лише у збірках під CUDA 13.0, яким потрібен драйвер R580 або новіший.
- Навчіть пілотну групу до відкриття доступу: що можна вводити, як перевірити цитоване джерело, як повідомити про хибну відповідь.
- Виміряйте одночасні запити, час до першого токена і якість відповідей та розрахуйте робочі сервери за цими даними.
- Відкривайте асистента наступному відділу, коли метрики досягнуто, і додайте другий сервер, перш ніж від нього залежатиме вся компанія.
Часті питання
З чого складається власна альтернатива ChatGPT?
Основу складають сервер моделі на кшталт vLLM і чат-інтерфейс Open WebUI або LibreChat. До них додають SSO, перевірку прав на документи, журнал зі строком зберігання, запобіжники, модель із придатною ліцензією та GPU під пікове навантаження.
Чи можна розгорнути аналог ChatGPT, який не передає дані назовні?
Так: gpt-oss-120b у vLLM на ваших GPU й Open WebUI чи LibreChat у вашій мережі. Вимкніть Direct Connections, відкрийте порт vLLM лише хосту інтерфейсу, задайте VLLM_NO_USAGE_STATS=1, а в Open WebUI увімкніть OFFLINE_MODE, інакше він завантажує моделі й перевіряє оновлення.
Чи потрібна комерційна ліцензія на Open WebUI?
Для внутрішнього використання ні, доки брендинг Open WebUI помітний. Змінювати чи прибирати брендинг, коли за 30 днів понад 50 кінцевих користувачів, можна лише з письмового дозволу правовласника або за корпоративною ліцензією. LibreChat поширюється за MIT без такого пункту.
Скільки GPU потрібно для корпоративного чату?
Залежить від пікової кількості одночасних запитів і заявленого контексту. Одна RTX PRO 6000 на 96 ГБ з gpt-oss-120b тримає близько 19 розмов по 32K, сервер із чотирма RTX PRO 6000 Server Edition від 76 до близько 186, що треба підтвердити навантажувальним тестом. Для доступності потрібен другий хост.
Яка відкрита модель підходить для асистента українською?
За ліцензією найпростіші моделі під Apache 2.0: gpt-oss, Qwen3-32B, Gemma 4. На лідерборді lang-uk найвищі бали має Gemma 4 26B A4B у режимі міркувань; MamayLM v2.0 зроблена для української, але має Gemma Terms of Use. Вибирайте після тесту на власних запитах.
Що з цього є в ETE
- ETE AI Workstation: одна RTX PRO 6000 на 96 ГБ, тобто gpt-oss-120b і близько 19 розмов по 32K для пілотної групи.
- ETE AI Server RTX PRO: чотири RTX PRO 6000 Server Edition по 96 ГБ, саме та конфігурація з розрахунку: близько 76 розмов по 32K у чотирьох копіях або близько 186 у двох парах.
- ETE AI XL43: вісім RTX PRO 6000 Server Edition, коли одного чотирикарткового сервера замало.
Плануєте власний ChatGPT для компанії?
Напишіть, скільки людей користуватиметься асистентом і скільки запитів очікуєте одночасно в пікову годину, який у вас провайдер ідентичності, де лежать документи і яку модель розглядаєте. ETE порахує конфігурацію, а за потреби інженери Vixen.UNO розгорнуть vLLM, інтерфейс і SSO.










