Вопрос приходит примерно так: «взяли один DGX Spark, уперлись, брать второй?». Ответ зависит не от желания масштабироваться, а от того, во что именно вы уперлись. Если в объём памяти, второй узел поможет. Если в скорость генерации, он не поможет никак. Ниже цифры из официальных спецификаций, живые замеры из открытых тестов и объяснение, откуда в обзорах ходят две разные цифры о том, сколько миллиардов параметров тянет связка.
Коротко
- Один Spark: 128 ГБ общей памяти, пропускная 273 ГБ/с, инференс моделей до 200 миллиардов параметров
- Два узла сшиваются напрямую кабелем QSFP между портами ConnectX-7, без коммутатора
- Паспортные 200 Гб/с получают не все: в открытых замерах выходило 92 до 95 Гб/с, пока линки не привязали правильно
- Память удваивается, скорость генерации токенов нет: она держится на 273 ГБ/с каждого узла
- До трёх узлов соединяются прямыми кабелями, четвёртый требует коммутатора
Что умеет одна машина
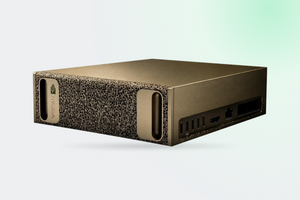
Коротко, потому что полный разбор одного узла с таблицей характеристик, историей про 119 ГиБ вместо 128 и объяснением питания уже есть в нашем обзоре NVIDIA DGX Spark: что он реально тянет. Главное оттуда: суперчип GB10 Grace Blackwell, 128 ГБ общей когерентной памяти LPDDR5x и пропускная способность 273 ГБ/с.
Официальный предел для одной машины: тонкая настройка моделей до 70 миллиардов параметров и инференс до 200 миллиардов. Именно объём здесь главное преимущество. Модель, которая не влезет в 96 ГБ профессиональной карты, в Spark влезет, и для этого не нужны ни стойка, ни три фазы, ни отдельный канал охлаждения. Плата за это честная и известна заранее: LPDDR5x вместо HBM, то есть объём куплен ценой пропускной способности.
Где оно упирается
В 273 ГБ/с. Это главное число, и оно объясняет все отзывы вида «модель загрузилась, но отвечает медленно». Генерация токенов это последовательное чтение весов модели из памяти на каждый токен. Сколько бы ни было вычислительной мощности, быстрее памяти оно не пойдёт.
Замеры на gpt-oss 120B сведены в обзоре одного узла: чтение запроса около 1725 токенов в секунду, генерация от 38,6 до 55,4 в зависимости от движка и формата. То есть запрос машина прочитывает мгновенно, а ответ печатает примерно со скоростью человеческого чтения вслух.
Важная оговорка, без которой картина выходит кривой: всё это цифры одного пользователя. Когда запросов много, веса читаются один раз на целую пачку, и та же gpt-oss 120B на vLLM выдаёт 862 токена в секунду суммарно при 256 одновременных запросах. Поэтому «медленно» относится к сценарию «я и одна большая модель», а не к команде, которая ходит в общий ассистент.
Чем сшиваются два узла
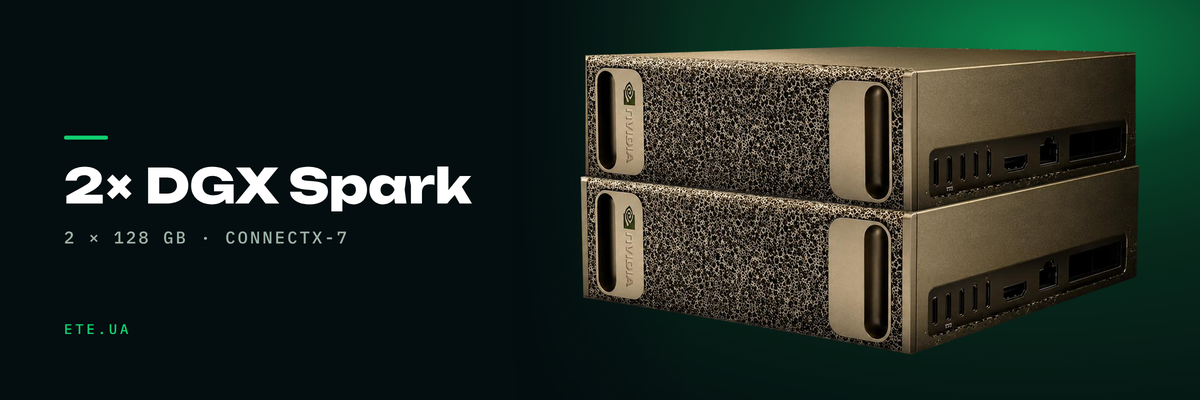
В каждом Spark стоит ConnectX-7 с двумя портами QSFP по 200 Гб/с. Два узла соединяются напрямую, кабель из порта в порт, коммутатор не нужен. Официальный сценарий NVIDIA «Connect Two Sparks» описывает ровно это: физическое соединение, настройка сетевых интерфейсов через netplan, беспарольный SSH между узлами. На весь маршрут заложено около часа.
Кабель нужен конкретный: пассивный DAC QSFP112 длиной 0,5 м. NVIDIA перечисляет две валидированные модели, Amphenol NJAAKK-N911 и Luxshare LMTQF022-SD-R. Комплектный кабель PNY QSFP to QSFP 112G на 0,5 м сделан под ту же спецификацию, поэтому искать что-то длиннее или активное не надо. Полметра это не ошибка проектировщика: два корпуса стоят рядом на столе.
Сколько на самом деле даёт 200 Гб/с
Здесь начинается то, чего нет в рекламных материалах. В тестах ServeTheHome полные 185 до 190 Гб/с снимались только после того, как интерфейсы привязали к правильным 100-гигабитным MAC на одной из клеток QSFP. Пока привязка была произвольная, оба линка шли через один канал PCIe Gen5 x4 и давали 92 до 95 Гб/с. Половина паспортной цифры, и никакой ошибки в конфигурации при этом не видно: оно просто работает вдвое медленнее.
Практический вывод простой. Закладывайте в план день на настройку сети и проверяйте результат замерами RDMA, а не тем, что линк поднялся.
Сколько узлов можно связать
Правило короткое: до трёх узлов соединяются прямыми кабелями, четвёртый требует коммутатора. Разница не в настройке, а в бюджете и месте: три коробки на столе против стойки с коммутатором.
Потолок, который NVIDIA называет сегодня: четыре системы и модели до 700 миллиардов параметров. Цифра «405 миллиардов на двух Spark», которая встречается в обзорах, тоже от NVIDIA: это формулировка с момента запуска, когда связка ограничивалась двумя машинами, и она до сих пор стоит на страницах партнёров, копирующих текст производителя дословно. Обе цифры свои, просто 405 это предыдущая редакция.
Кому хватит одного
Одного хватит, если ваша модель помещается в 128 ГБ и вы разрабатываете, а не обслуживаете поток пользователей. Прототип, тонкая настройка модели до 70 миллиардов, локальный ассистент для команды, работа с чувствительными данными, которые нельзя отдавать в облако: всё это закрывается одной коробкой под столом, без стойки, без промышленной розетки и без отдельного кондиционера.
Второй узел имеет смысл в двух случаях. Первый: модель не влезает в 128 ГБ, и вам нужна именно память. Второй: вы осваиваете распределённое обучение как инженерную практику, и вам нужен настоящий второй узел с настоящим NCCL, а не имитация.
В остальных случаях счёт такой: памяти вдвое больше, скорости ответа столько же. Замеры на связке показывают, что чтение запроса ускоряется от 6 до 25 процентов в зависимости от модели, а генерация не ускоряется вообще или даже проседает. Причина та же 273 ГБ/с: она у каждого узла своя и от соседа не увеличивается.
Если упирается именно скорость генерации, смотреть надо не в сторону второго Spark, а в сторону карт с памятью HBM, где пропускная измеряется тысячами гигабайт в секунду.
NVIDIA DGX Spark есть в наличии в Киеве. Самовывоз или отправка в день заказа, комплектный кабель для связки двух узлов заказывается отдельно.
Карточка DGX Spark с характеристиками. Назовите модель и задачу, скажем, во что упрётся именно ваша: в объём памяти или в пропускную, и нужен ли второй узел.