Кластер из двух или четырёх узлов упирается не в видеокарты, а в то, чем эти узлы сшиты. Вопрос звучит одинаково от всех, кто собирает первую машину под обучение моделей: брать InfiniBand или хватит Ethernet на 100 Гбит/с. Ниже цифры из даташитов, то, что придётся настроить в обоих случаях, и граница, после которой Ethernet перестаёт быть дешёвым вариантом.
Коротко
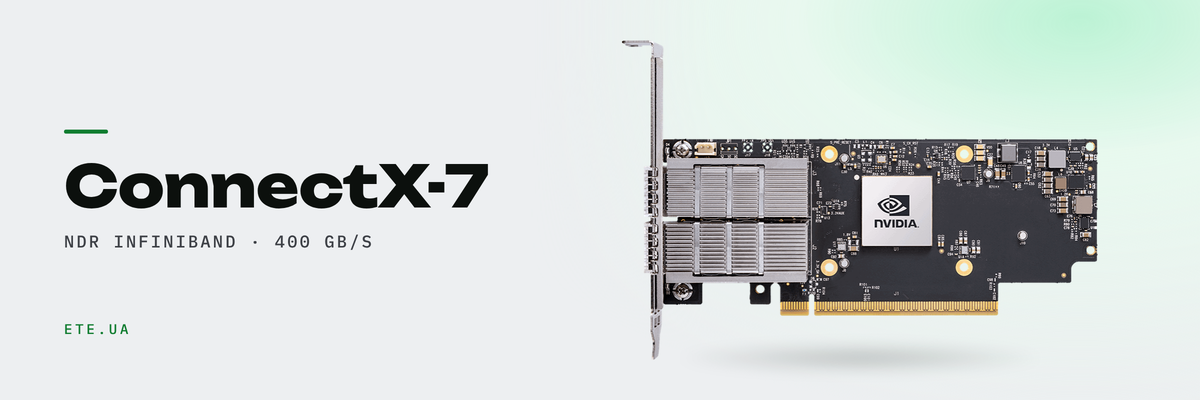
- ConnectX-7 отдаёт 400 Гбит/с на порт и от 330 до 370 миллионов RDMA-сообщений в секунду, интерфейс к хосту PCIe Gen5
- VPI-карта переключается между InfiniBand и Ethernet командой mlxconfig, то есть протокол не замуровывается при покупке
- Фабрика InfiniBand не поднимется без subnet manager. В MQM9700 он внутри и тянет до 2000 узлов, у MQM9790 такого нет
- RoCE на коммутаторах Spectrum включается командой nv set qos roce, режим по умолчанию lossless с PFC и ECN
- Один порт OSFP на Quantum-2 несёт 800 Гбит/с, то есть два NDR по 400. Отсюда 64 порта из 32 клеток и нужда в сплиттерных кабелях
Что именно бегает между узлами
Внутри узла карты общаются по NVLink и PCIe, туда сеть не лезет. Наружу выходит ровно один тип трафика: синхронизация. На каждом шаге обучения узлы обмениваются градиентами, и пока этот обмен идёт, вычисления стоят. Поэтому сеть в кластере меряют не скоростью копирования файлов, а тем, сколько мелких сообщений в секунду она протянет.
Для инференса картина другая. Если модель помещается в память одного узла, между узлами почти ничего не ходит: запрос пришёл, ответ ушёл, соседние машины об этом не знают. Кластер из четырёх таких узлов прекрасно живёт на обычном Ethernet, потому что сеть обслуживает пользователей, а не вычисления.
Граница проходит там, где модель перестаёт помещаться в узел. Тогда веса режутся между машинами, и каждый токен на генерации тянет обмен по сети. Вот здесь задержка начинает стоить денег.
Цифры ConnectX-7 из даташита
Даташит NVIDIA даёт такие параметры: суммарная полоса 400 Гбит/с, соответствие спецификации IBTA 1.5, от одного до четырёх сетевых портов, хостовый интерфейс PCIe Gen5 до 32 линий. Скорость RDMA-сообщений заявлена как 330 до 370 миллионов в секунду. В кремний встроены движки ускорения: коллективные операции, MPI All-to-All, MPI tag matching и программируемый ускоритель датапаса.
Последняя строчка важнее, чем кажется. Коллективные операции на карте означают, что часть работы all-reduce делает сеть, а не процессор узла. На Ethernet ту же работу придётся делать софтом.
Одна карта под два протокола
Путаница начинается с названий в прайсе: «400GbE (default mode) / NDR IB» выглядит как две разные карты в одной строке. Это одна карта. Порт ConnectX переключается между InfiniBand и Ethernet параметром прошивки, документация на mlxconfig описывает это как LINK_TYPE_P1 со значениями 1 для InfiniBand и 2 для Ethernet. После смены нужна перезагрузка, больше ничего.
Практический вывод простой. Если вы колеблетесь между протоколами, возьмите VPI-карту и решайте позже, на живой нагрузке. Ошибка обойдётся в перезагрузку, а не в новый заказ.
| Модель | Режимы | Порты | Кому |
|---|---|---|---|
| MCX75310AAS-NEAT | NDR InfiniBand, 400 Гбит/с | 1 × OSFP, PCIe 5.0 x16 | обучение на нескольких узлах |
| MCX715105AS-WEAT | 400GbE или NDR, переключается | 1 × QSFP112, PCIe 5.0 x16 | когда протокол ещё не решён |
| MCX755106AS-HEAT | 200GbE или NDR200 | 2 × QSFP112, PCIe 5.0 x16 | два порта под резерв или две фабрики |
| MCX713104AS-ADAT | 25 и 50GbE, только Ethernet | 4 × SFP56, PCIe 4.0 x16 | хранилище, VDI, управление |
InfiniBand не работает без subnet manager
Это то место, где первый кластер встаёт на сутки. В Ethernet вы включили коммутатор и линк поднялся. В InfiniBand фабрике нужно раздать адреса и построить маршруты, и пока этого не случилось, порты светятся, а трафик не идёт. Документация MLNX_OFED формулирует жёстко: subnet manager должен работать в фабрике постоянно, запускать его можно на любом узле или на коммутаторе, в составе OFED для этого есть OpenSM.
Отсюда разница между двумя коммутаторами, которые в каталоге выглядят одинаково. MQM9700 управляется сам: subnet manager внутри, по документации на серию QM97XX он поднимает фабрику до 2000 узлов без сторонних сервисов. MQM9790 управляется извне, под него нужен UFM или OpenSM на одном из серверов. Цена ниже, администрирование дороже.
Остальные цифры по обоим: 64 неблокируемых порта NDR и до 51,2 Тбит/с суммарной полосы в обе стороны, 32 клетки OSFP, режим port-split даёт до 128 портов NDR200. Третье поколение SHARP считает коллективные операции внутри сети. Потребление по документации: у MQM9700 типовое 747 Вт и максимум 1720 Вт, у MQM9790 640 Вт и 1610 Вт. Планируйте питание стойки под максимум, а не под типовое.
Для двух узлов коммутатор не обязателен. Две карты соединяются кабелем напрямую, OpenSM поднимается на одном из хостов, фабрика работает. Минус в том, что этот хост становится точкой отказа: перезагрузили его, и сосед остался без маршрутов.
Ethernet тоже приходится готовить
Аргумент «Ethernet проще» держится ровно до того момента, когда на нём надо запустить RDMA. RoCE поверх обычного коммутатора без настроек даст потери пакетов на первом же всплеске, и скорость обучения просядет так, что дешевле было взять InfiniBand.
Хорошая новость: на коммутаторах Spectrum с Cumulus Linux это одна команда. Документация Cumulus описывает nv set qos roce со следующим за ним nv config apply. Режим по умолчанию lossless: включается PFC на приоритете 3 и выделяется отдельный буфер под RoCE. Режим lossy оставляет только ECN, сигнализацию о перегрузке по RFC 3168. Там же написано то, о чём забывают: хосты должны поддерживать RoCE, сам по себе коммутатор ничего не решает.
Что из нашего ассортимента закрывает эту часть. MSN4600-CS2FC на Spectrum-3 даёт 64 порта QSFP28 со скоростями от 1 до 100 Гбит/с, это рабочая магистраль для кластера на 100GbE. MSN3420-CB2RC на Spectrum-2 имеет 48 портов SFP28 и 12 портов QSFP28, то есть 25 Гбит/с до узлов и 100 Гбит/с в аплинк. Для сети управления есть MSN2201-CSMRC с 48 портами RJ45. Отдельная сеть управления выглядит излишеством ровно до первой ночи, когда основная фабрика легла и до серверов не достучаться.
Кабели: половина сюрпризов в бюджете
На NDR клетка OSFP несёт 800 Гбит/с, то есть два порта по 400. Из-за этого 32 физические клетки Quantum-2 и дают 64 порта NDR. Следствие для закупки: кабель от коммутатора к двум узлам чаще всего сплиттерный, один OSFP со стороны коммутатора и два разъёма со стороны карт. Посчитать кабели как «по одному на узел» означает заказать вдвое больше, чем нужно.
В пределах стойки берут пассивную медь: она ничего не потребляет и не греется. Когда расстояние больше нескольких метров, в игру входит активная медь, дальше оптика с трансиверами и патч-кордами MPO12. Список того, что есть на складе, лежит в разделе сетевого оборудования NVIDIA: сплиттеры на 800 Гбит/с, DAC и AOC на 100 и 200 Гбит/с, трансиверы SR4 и оптические сборки под NDR.
Когда хватит Ethernet
| Что делаете | Сеть | Почему так |
|---|---|---|
| Инференс, модель помещается в узел | 25 или 100GbE | между узлами ходят запросы пользователей, а не веса |
| VDI, рендер, обработка видео | 25GbE до узла, 100GbE в аплинк | нагрузка упирается в хранилище, не в синхронизацию |
| Файнтюн на двух узлах | 200GbE с RoCE или NDR200 напрямую | обмен есть, но масштаба фабрики ещё нет |
| Обучение на четырёх и более узлах | NDR и Quantum-2 | all-reduce на каждом шаге, здесь работают SHARP и адаптивная маршрутизация |
| Модель разрезана между узлами | только NDR | каждый токен тянет обмен, задержка становится видна пользователю |
Чего эта статья не обещает
Мы не назовём процент прироста для вашей модели. Выигрыш InfiniBand зависит от доли коммуникаций в шаге обучения, а она разная у 8B и 70B, у полного файнтюна и у LoRA. Честный ответ выглядит так: если на ваших задачах узлы большую часть времени считают, разница будет заметна только в логе профайлера. Если ждут друг друга, разницу увидите по часам на эпоху.
Второе. Цена фабрики InfiniBand это не только коммутатор. Добавьте карты, сплиттерные кабели, оптику, если стойки разнесены, и человека, который умеет читать вывод ibdiagnet. Для двух узлов под инференс такая конструкция окупится не быстрее, чем никогда.
Эти модели есть в каталоге


Посчитаем сеть под ваш кластер
Напишите, сколько узлов, какие карты внутри и что на них считается. Подберём адаптеры, коммутатор и кабельную обвязку, а заодно скажем, где в вашем случае InfiniBand не окупится.
Получить консультацию