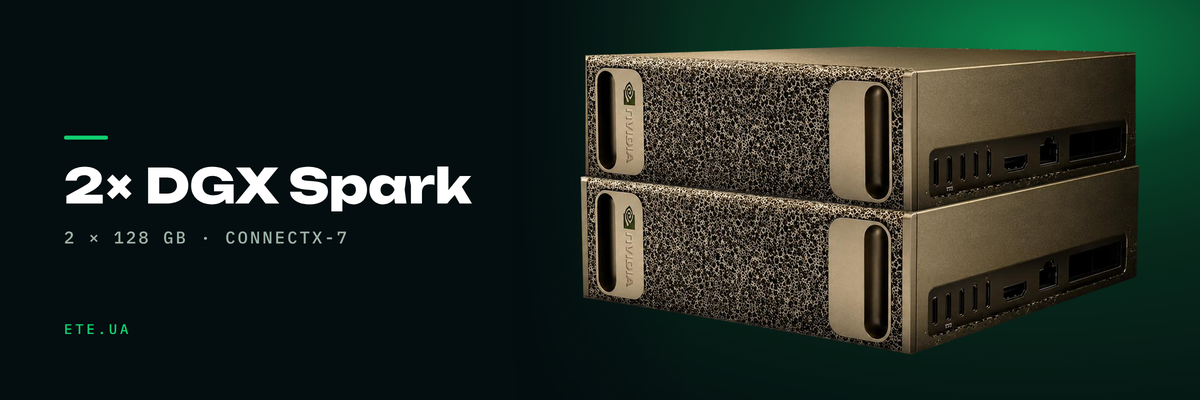
Питання звучить приблизно так: «взяли один DGX Spark, вперлися, брати другий?». Відповідь залежить не від бажання масштабуватись, а від того, у що саме ви вперлися. Якщо в обсяг пам'яті, другий вузол допоможе. Якщо у швидкість генерації, він не допоможе ніяк. Нижче цифри з офіційних специфікацій, живі заміри з відкритих тестів і пояснення, звідки в оглядах ходять дві різні цифри про те, скільки мільярдів параметрів тягне зв'язка.
Коротко
- Один Spark: 128 ГБ спільної пам'яті, пропускна 273 ГБ/с, інференс моделей до 200 мільярдів параметрів
- Два вузли зшиваються напряму кабелем QSFP між портами ConnectX-7, без комутатора
- Паспортні 200 Гб/с отримують не всі: у відкритих замірах виходило від 92 до 95 Гб/с, поки з'єднання не прив'язали правильно
- Пам'ять подвоюється, а швидкість генерації токенів ні: вона тримається на 273 ГБ/с кожного вузла
- До трьох вузлів з'єднуються прямими кабелями, четвертий потребує комутатора
Що вміє одна машина
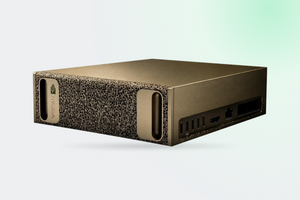
Коротко, бо повний розбір одного вузла з таблицею характеристик, історією про 119 ГіБ замість 128 і поясненням живлення вже є в нашому огляді NVIDIA DGX Spark: що він реально тягне. Головне звідти: суперчип GB10 Grace Blackwell, 128 ГБ спільної когерентної пам'яті LPDDR5x і пропускна здатність 273 ГБ/с.
Офіційна межа для однієї машини: тонке налаштування моделей до 70 мільярдів параметрів і інференс до 200 мільярдів. Саме обсяг тут головна перевага. Модель, яка не влізе в 96 ГБ професійної карти, у Spark влізе, і для цього не потрібні ні стійка, ні три фази, ні окремий канал охолодження. Плата за це чесна й відома заздалегідь: LPDDR5x замість HBM, тобто обсяг куплений ціною пропускної здатності.
Де воно впирається
У 273 ГБ/с. Це головне число, і воно пояснює всі відгуки на кшталт «модель завантажилась, але відповідає повільно». Генерація токенів це послідовне читання ваг моделі з пам'яті на кожен токен. Скільки б не було обчислювальної потужності, швидше за пам'ять воно не піде.
Заміри на gpt-oss 120B зведені в огляді одного вузла: читання запиту близько 1725 токенів за секунду, генерація від 38,6 до 55,4 залежно від рушія й формату. Тобто запит машина прочитує миттєво, а відповідь друкує приблизно зі швидкістю людського читання вголос.
Важливе застереження, без якого картина виходить кривою: усе це цифри одного користувача. Коли запитів багато, ваги читаються один раз на цілу пачку, і та сама gpt-oss 120B на vLLM видає 862 токени за секунду сумарно при 256 одночасних запитах. Тому «повільно» стосується сценарію «я і одна велика модель», а не команди, яка ходить у спільний асистент.
Чим зшиваються два вузли
У кожному Spark стоїть ConnectX-7 із двома портами QSFP по 200 Гб/с. Два вузли з'єднуються навпростець, кабель із порту в порт, комутатор не потрібен. Офіційний сценарій NVIDIA «Connect Two Sparks» описує рівно це: фізичне з'єднання, налаштування мережевих інтерфейсів через netplan, безпарольний SSH між вузлами. На весь маршрут закладено близько години.
Кабель потрібен конкретний: пасивний DAC QSFP112 довжиною 0,5 м. NVIDIA перелічує дві валідовані моделі, Amphenol NJAAKK-N911 і Luxshare LMTQF022-SD-R. Комплектний кабель PNY QSFP to QSFP 112G на 0,5 м зроблений під цю саму специфікацію, тому шукати щось довше чи активне не треба. Півметра це не помилка проєктувальника: два корпуси стоять поруч на столі.
Скільки насправді дає 200 Гб/с
Тут починається те, чого немає в рекламних матеріалах. У тестах ServeTheHome повні від 185 до 190 Гб/с знімались лише після того, як інтерфейси прив'язали до правильних 100-гігабітних MAC на одній із кліток QSFP. Поки прив'язка була довільна, обидва з'єднання йшли через один канал PCIe Gen5 x4 і давали від 92 до 95 Гб/с. Половина паспортної цифри, і ніякої помилки в конфігурації при цьому не видно: воно просто працює вдвічі повільніше.
Практичний висновок простий. Закладайте в план день на налаштування мережі й перевіряйте результат замірами RDMA, а не тим, що з'єднання піднялось.
Скільки вузлів можна зв'язати
Правило коротке: до трьох вузлів з'єднуються прямими кабелями, четвертий потребує комутатора. Різниця не в налаштуванні, а в бюджеті й місці: три коробки на столі проти стійки з комутатором.
Стеля, яку NVIDIA називає сьогодні: чотири системи й моделі до 700 мільярдів параметрів. Цифра «405 мільярдів на двох Spark», яка трапляється в оглядах, теж від NVIDIA: це формулювання з моменту запуску, коли зв'язка обмежувалась двома машинами, і воно досі стоїть на сторінках партнерів, які копіюють текст виробника дослівно. Обидві цифри свої, просто 405 це попередня редакція.
Кому вистачить одного
Одного вистачить, якщо ваша модель уміщується в 128 ГБ і ви розробляєте, а не обслуговуєте потік користувачів. Прототип, тонке налаштування моделі до 70 мільярдів, локальний асистент для команди, робота з чутливими даними, які не можна віддавати в хмару: усе це закривається однією коробкою під столом, без стійки, без промислової розетки й без окремого кондиціонера.
Другий вузол має сенс у двох випадках. Перший: модель не влазить у 128 ГБ, і вам потрібна саме пам'ять. Другий: ви опановуєте розподілене навчання як інженерну практику, і вам потрібен справжній другий вузол зі справжнім NCCL, а не імітація.
У решті випадків рахунок такий: пам'яті вдвічі більше, швидкості відповіді стільки ж. Заміри на зв'язці показують, що читання запиту прискорюється від 6 до 25 відсотків залежно від моделі, а генерація не прискорюється взагалі або навіть просідає. Причина та сама 273 ГБ/с: вона в кожного вузла своя й від сусіда не збільшується.
Якщо впирається саме швидкість генерації, дивитись треба не в бік другого Spark, а в бік карт із пам'яттю HBM, де пропускна вимірюється тисячами гігабайт за секунду.
NVIDIA DGX Spark є в наявності в Києві. Самовивіз або відправлення в день замовлення, комплектний кабель для зв'язки двох вузлів замовляється окремо.
Картка DGX Spark із характеристиками. Назвіть модель і завдання, скажемо, у що впреться саме ваша: в обсяг пам'яті чи в пропускну, і чи потрібен другий вузол.