
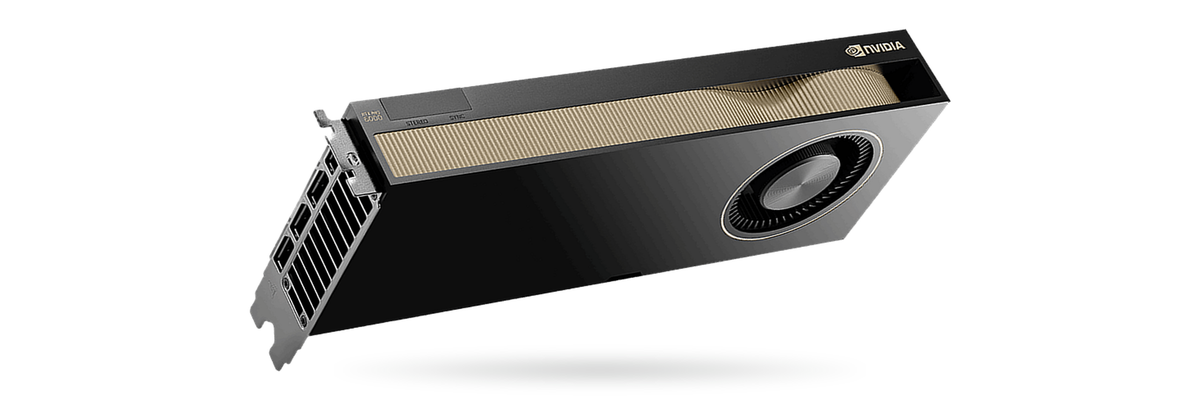
Альтернатива Otter, при которой записи не уходят в облако, это открытое веб-приложение на рабочей станции в офисе. Оно принимает аудиофайл, делает стенограмму с разметкой спикеров, составляет итоги локальной языковой моделью и отдаёт текст на экспорт. По состоянию на октябрь 2026 года для этого есть два готовых проекта, Scriberr и Whishper, и любому из них для команды хватает одной NVIDIA RTX PRO 4500 Blackwell на 32 ГБ. Отказаться придётся прежде всего от бота, который сам подключается к видеозвонкам, и от мобильных приложений.
Расчёт памяти для больших серверов приведён в статье о сервере распознавания речи под Whisper. Здесь речь о приложении, в котором команда работает каждый день, об украинском и русском языке и о том, что требует Закон Украины № 2297-VI от записей разговоров.
Коротко
- Локальное приложение повторяет цикл Otter (загрузка, стенограмма со спикерами, итоги, экспорт) на машине компании, и записи не покидают её периметр.
- Scriberr (MIT) запускает Parakeet, Canary и Whisper, размечает спикеров и делает итоги через Ollama; Whishper (AGPL-3.0) работает на faster-whisper и имеет редактор субтитров.
- На украинском FLEURS в статье NVIDIA у Whisper large-v3 WER 6,51 %, у Parakeet TDT 0.6B v3 6,79 %, у Canary-1B v2 10,50 %.
- Разработка Scriberr приостановлена с обещанием возобновить (последняя версия v1.2.0), основная ветка Whishper заморожена, пока переписывается версия 4.
- По нашей оценке, RTX PRO 4500 на 32 ГБ одновременно вмещает Whisper large и модель итогов gpt-oss-20b.
Otter или своё приложение: что изменится для команды
На главной странице, прочитанной 30 октября 2026 года, Otter описывает агента для совещаний: транскрибация в реальном времени, чат, автоматические итоги и задачи. Через Google Calendar агент сам заходит на встречи в Zoom, Teams и Google Meet; есть и приложения для iOS и Android. Happy Scribe в тот же день обещал транскрибацию на более чем 150 языках, субтитры, экспорт в DOCX, PDF, SRT и VTT и хранение записей в ЕС. Передачу данных в государства ЕЭЗ статья 29 Закона № 2297-VI допускает, но обработчик всё равно остаётся внешним. Локальное приложение его убирает.
| Функция | Otter (главная страница) | Scriberr | Whishper |
|---|---|---|---|
| Загрузка записей | импорт аудио и видео | да, плюс наблюдение за папкой | да |
| Запись в приложении | десктоп, мобильный, браузер | встроенный диктофон | в README не упомянуто |
| Участие в видеозвонках | агент через календарь | в README не упомянуто | в README не упомянуто |
| Разметка спикеров | да | да, через PyAnnote | в README не упомянуто |
| Итоги и вопросы к тексту | да | через Ollama или OpenAI-совместимый сервер | нет |
| Субтитры и перевод | на главной не упомянуто | в README не упомянуто | редактор, SRT и VTT, LibreTranslate |
| Где работает | сервис поставщика | ваша машина | ваша машина |
Источник: главная страница Otter; README Scriberr и Whishper на GitHub; прочитано 30.10.2026.
Аудио, стенограмма и итоги остаются на станции, если модель итогов тоже работает на ней. Scriberr умеет обращаться к любому провайдеру с OpenAI-совместимым API, а с версии v1.2.0 ещё и транскрибировать через OpenAI, поэтому куда уйдут данные, решает тот, кто настраивает приложение. В локальном варианте итоги считает Ollama или vLLM на той же машине. Встреча в Zoom или Teams всё равно идёт через их сервис, так что в приложение обычно загружают запись с компьютера участника или файл с диктофона.
Scriberr, Whishper, WhisperX и Speaches: сравнение открытых проектов
Из четырёх проектов два представляют собой готовые веб-приложения для пользователей, ещё два служат строительными блоками для ИТ-отдела.
| Проект | Лицензия | Тип | Движок распознавания | Состояние (октябрь 2026) |
|---|---|---|---|---|
| Scriberr | MIT | веб-приложение | Parakeet, Canary, Whisper | v1.2.0; разработка приостановлена, возобновление анонсировано |
| Whishper | AGPL-3.0 | веб-приложение | faster-whisper | основная ветка заморожена; переписывают версию 4 |
| WhisperX | BSD-2-Clause | инструмент на Python и CLI | Whisper на faster-whisper | 3.8.6 от 25.05.2026 |
| Speaches | MIT | сервер речевого API | faster-whisper | v0.9.0-rc.3, кандидат в релиз |
Источник: страницы Scriberr, Whishper и Speaches на GitHub, страница WhisperX на PyPI, прочитано 30.10.2026. Звёзды на GitHub: Scriberr 3,1 тыс., Whishper 3,1 тыс., Speaches 3,7 тыс.
Scriberr по собственному описанию является полностью офлайновым приложением. Он ставит метки времени для каждого слова, сам определяет спикеров и через подключённую языковую модель отвечает на вопросы по стенограмме. Просмотрщик текста следует за звуком при воспроизведении, фрагменты можно выделять и комментировать, наблюдатель за папкой подхватывает новые файлы, а версия v1.2.0 добавила вебхуки и утилиту командной строки. Форматы экспорта и роли пользователей README не перечисляет, поэтому рассчитывайте на одно общее рабочее пространство на команду внутри корпоративной сети.
Whishper транскрибирует и переводит локально через веб-интерфейс. Его редактор субтитров делит сегменты, предупреждает о слишком большом числе символов в секунду и подсвечивает текст при воспроизведении; экспорт возможен в TXT, JSON, VTT и SRT. Аутентификация пользователей пока только в планах, поэтому приложение ставят в доверенную внутреннюю сеть или за обратный прокси с авторизацией.
WhisperX рассчитан на ИТ-команды. Страница на PyPI обещает пакетную обработку в 70 раз быстрее реального времени на whisper large-v2 и менее 8 ГБ видеопамяти. Метки времени для слов даёт выравнивание wav2vec2, стандартные модели которого предусмотрены для английского, французского, немецкого, испанского и итальянского; у четырёх неанглийских некоммерческая лицензия CC BY-NC 4.0. Украинского и русского в этом списке нет, поэтому модель выравнивания для них задают отдельно и проверяют её лицензию.
Speaches представляет собой сервер с OpenAI-совместимым API для транскрибации, перевода и синтеза речи. Он уместен, когда компании нужен один центральный речевой сервис для других программ, например для диктовки. Версия v0.9.0-rc.3 имеет статус кандидата в релиз, так что фиксируйте ту, которую разворачиваете.
Точность распознавания украинского и русского в Scriberr и Whishper
Сами приложения речь не распознают, всё зависит от модели под ними. Whisper large-v3, Parakeet TDT 0.6B v3 и Canary-1B v2 поддерживают оба языка, а сравнение по единой методике есть в статье NVIDIA.
| Модель | Лицензия | WER uk, FLEURS, % | WER ru, FLEURS, % |
|---|---|---|---|
| Whisper large-v3 | MIT | 6,51 | 4,17 |
| Parakeet TDT 0.6B v3 | CC-BY-4.0 | 6,79 | 5,51 |
| Canary-1B v2 | CC-BY-4.0 | 10,50 | 6,90 |
Источник: статья NVIDIA arXiv 2509.14128; лицензии по репозиторию OpenAI и карточкам моделей; прочитано 13.11.2026.
WER показывает долю ошибочно распознанных слов. FLEURS состоит из прочитанных предложений, поэтому на совещаниях и звонках ошибок будет заметно больше. Одна и та же модель в разных измерениях даёт разные цифры: в рейтинге Handy (FLEURS, веса Q8_0) у Parakeet v3 на украинском 6,84 %, а для русского самый низкий WER там у Whisper large-v3, 4,96 %. Опубликованных измерений на суржике или на смешанных украинско-русских совещаниях мы не нашли. Подробнее о моделях для обоих языков рассказано в статье о локальном распознавании украинского и русского.
Карточка pyannote speaker-diarization-community-1 не приводит DER для украинского или русского, так что разметку спикеров проверяйте на своих записях. Для перевода через LibreTranslate опубликованных данных по украинскому мы не нашли.
Поддержка проектов и лицензии для компании
Оба веб-приложения развивают небольшие команды. В README Scriberr есть раздел без даты: разработка «пока приостановлена, но точно не заброшена», а строка вверху обещает вернуться к работе «на этой неделе»; последняя версия по-прежнему v1.2.0, так что перед установкой посмотрите историю коммитов. Основная ветка Whishper, по его README, новых версий больше не получит. Работать программы от этого не перестанут, но установленную версию стоит зафиксировать, образ контейнера и модели держать на собственном хранилище, а человека, который ставит исправления безопасности, назначить заранее.
Scriberr распространяется по MIT. У Whishper лицензия AGPL-3.0, раздел 13 которой требует, чтобы изменённая версия предлагала свой код пользователям, работающим с ней по сети; если вы меняете код, этот раздел сначала читает юрист. Код и веса Whisper OpenAI выпускает по MIT. Scriberr использует среду WhisperX, поэтому стоит проверить, какую модель выравнивания он загружает для украинского и русского, и поставить ту, что разрешает коммерческое использование. Parakeet и Canary лицензированы по CC BY 4.0 и, согласно карточкам, готовы к коммерческому применению. Pyannote community-1 тоже под CC BY 4.0, но с ограниченным доступом: после принятия условий и токена Hugging Face локальная копия работает без интернета.
Как запустить Scriberr на RTX PRO Blackwell
У Scriberr три варианта Docker-образов: для CPU, с CUDA для GPU от Pascal до Ada и scriberr-cuda-blackwell. Для карт RTX 50 README требует именно образ для Blackwell, так как стандартный не работает из-за совместимости PyTorch и CUDA. Карты RTX PRO в README не названы, но образ привязан к sm_120, а это вычислительная способность RTX PRO Blackwell; первый тест после установки это подтверждает.
Для доступа к GPU нужен NVIDIA Container Toolkit, первый запуск несколько минут скачивает модели PyAnnote, а для машины без интернета все модели нужно заранее сохранить локально. Именно здесь первая установка обычно и застревает. ETE может поставить саму станцию, а инженеры Vixen.UNO отдельно или вместе с ней устанавливают Scriberr или Whishper с моделями распознавания и итогов.
Какая видеокарта нужна для транскрибации
Распознавание нагружает GPU немного. В статье об Open ASR Leaderboard (arXiv 2510.06961v3, декабрь 2025) на одной A100 с пакетом 64 Whisper large-v3 обрабатывал 145,5 секунды аудио за секунду, а Parakeet TDT 0.6B v3 около 3 333. По нашему расчёту, часовая запись занимает там примерно 25 секунд у Whisper и около секунды у Parakeet. Для карт RTX PRO таких цифр мы не нашли, а скорость разметки спикеров карточка pyannote не указывает. Поэтому карту определяют два вопроса: работает ли модель итогов рядом и сколько загрузок идёт одновременно.
| Уровень | Карта и память | Что работает | Для кого |
|---|---|---|---|
| Начальная станция | 1 × RTX PRO 4000 Blackwell, 24 ГБ | распознавание с разметкой спикеров; итоги выключены или по очереди | одна команда, загрузки в очереди |
| Основная станция | 1 × RTX PRO 4500 Blackwell, 32 ГБ | Whisper large и gpt-oss-20b вместе | команда или отдел с итогами |
| Станция с запасом | 1 × RTX PRO 5000 Blackwell, 48 или 72 ГБ | несколько задач параллельно | несколько отделов одновременно |
| Сервер компании | 2 × RTX PRO 6000 Server Edition | распознавание в инстансах MIG, gpt-oss-120b для итогов | сервис для всей компании |
Источник: полезная память по нашему правилу (90 % памяти, которую показывает драйвер, минус 3 ГиБ): 18,5; 25,7; 40,0 или 61,5 ГиБ; Whisper large около 10 ГБ (репозиторий OpenAI), веса gpt-oss-20b 13,76 ГБ (Hugging Face); наша оценка.
Whisper large занимает около 10 ГБ, то есть 9,3 ГиБ, а веса gpt-oss-20b (Apache 2.0) 13,76 ГБ, или 12,8 ГиБ. Вместе 22,1 ГиБ: больше, чем 18,5 ГиБ на карте 24 ГБ, и меньше, чем 25,7 ГиБ на RTX PRO 4500, где для рабочей памяти модели итогов остаётся около 3,6 ГиБ. Модель разметки спикеров добавляется сверху, а её потребность в памяти карточка pyannote не указывает. На карте 24 ГБ итоги запускают, когда модель распознавания выгружена, или на другой машине. RTX PRO 5000 на 48 ГБ после обеих моделей оставляет около 18 ГиБ для параллельных задач. Конфигурацию под ваших пользователей и часы аудио ETE считает от реальной нагрузки.
RTX PRO 4500 потребляет 200 Вт, так что станция с одной картой далека от 2,94 кВт, которые выдерживает линия 230 В на 16 А при нагрузке 80 %. Сервер с двумя RTX PRO 6000 Server Edition по 96 ГБ, по нашей оценке, берёт из розетки около 1,8 кВт; с учётом отключений в Украине его планируют вместе с ИБП и генератором (см. статью о питании станции с несколькими GPU). Схема с MIG на одной карте и gpt-oss-120b на другой описана в статье о протоколах совещаний с локальным AI.
Запись и транскрибация разговоров: что говорит украинское законодательство
Собственный сервер убирает внешнего поставщика, но не обязанности компании в отношении записей. Отдельного закона о записи разговоров коммерческими компаниями в Украине нет, поэтому действуют общие нормы: Конституция гарантирует тайну телефонных разговоров (ст. 31) и запрещает собирать конфиденциальную информацию о лице без его согласия, кроме случаев, определённых законом (ст. 32). Голос и записанный разговор относятся к персональным данным, так что нужно одно из шести оснований статьи 11 Закона № 2297-VI (согласие, договор, законный интерес и т. д.), а по статье 12 человеку заранее сообщают, кто и с какой целью ведёт запись и какие у него права.
На практике в начале разговора предупреждают о записи и называют цель, а аудио и стенограммы хранят ровно столько, сколько этой цели требуется. Приближенный к GDPR законопроект № 8153 по состоянию на ноябрь 2026 года не принят. Эта справка не является юридической консультацией, детали подтвердит ваш юрист.
Что проверить перед переходом
Возьмите от 20 до 30 минут типичного аудио (разговор с клиентом, совещание, голосовую заметку) и прогоните через оба приложения.
- Языки. Сравните точность на украинском, русском и смешанных записях; имена и числа считайте отдельно.
- Как приходит аудио. Определите, кто записывает и куда загружает файлы, или настройте наблюдатель Scriberr на общую папку.
- Экспорт. Если стенограммы должны попадать в Word, предусмотрите шаг конвертации.
- Доступ. Закройте приложение корпоративной авторизацией или VPN.
- Внешние вызовы. Проверьте, что итоги идут на локальную модель и ни один компонент не отправляет аудио в облако.
Для отдельных интервью исследователей и журналистов есть путь проще: noScribe на собственном компьютере.
Частые вопросы
Есть ли открытая альтернатива Otter, которую можно установить у себя?
Да, Scriberr и Whishper транскрибируют загруженные записи на вашей машине. Бота для звонков нет ни у одного, а поддержка обоих по состоянию на октябрь 2026 года под вопросом.
Scriberr или Whishper: что выбрать команде?
Scriberr под MIT подходит, если нужны спикеры, итоги и вопросы к стенограмме. Whishper под AGPL-3.0 удобнее для субтитров и переводов, но авторизации пользователей в нём пока нет.
Распознаёт ли Scriberr украинский язык?
Да, все три его движка поддерживают украинский и русский. На украинском FLEURS у Whisper large-v3 WER 6,51 %, у Parakeet v3 6,79 %, у Canary 10,50 %. Для суржика данных нет, так что проверьте модели на собственных записях.
Какая видеокарта нужна для сервера транскрибации?
Для одной команды, по нашей оценке, хватает RTX PRO 4500 на 32 ГБ с Whisper large и gpt-oss-20b одновременно. Карта на 24 ГБ распознаёт и размечает спикеров, но обе модели сразу не вмещает. Для нескольких отделов подходит RTX PRO 5000 на 48 ГБ.
Законно ли транскрибировать совещания локально в Украине?
Можно, если выполнены те же условия, что и для любой обработки записей: основание по статье 11 Закона № 2297-VI, предварительное информирование участников по статье 12 и определённый срок хранения. Детали для вашего случая подтвердит юрист.
Что из этого есть в ETE
- NVIDIA RTX PRO 4500 Blackwell 32 ГБ: Whisper large и gpt-oss-20b одновременно при 200 Вт.
- NVIDIA RTX PRO 5000 Blackwell 48 ГБ: запас памяти для параллельных задач нескольких отделов.
- NVIDIA RTX PRO 4000 SFF Blackwell 24 ГБ: те же 24 ГБ, что на начальном уровне, для распознавания с итогами по очереди.
- NVIDIA RTX PRO 6000 Server Edition 96 ГБ: две карты в сервере для MIG-распознавания и gpt-oss-120b.
Нужна станция для транскрибации под вашу команду?
Напишите, на каких языках вы работаете, сколько часов аудио в неделю обрабатываете и сколько человек будет пользоваться приложением. ETE рассчитает конфигурацию, а при необходимости инженеры Vixen.UNO установят Scriberr или Whishper с моделями.










